以 Stable Diffusion 3.5 和 FLUX 为代表的 Flow Matching 与 Rectified Flow 模型,凭借沿直线常微分方程(ODE)传输的简单几何结构,在推理速度与生成质量上取得了极佳表现。但恰恰是推理阶段的高效确定性(Determinism),在引入 Online RL 对齐人类偏好与复杂指令时成了直接障碍——基于 Policy Gradient 的方法同时依赖两个条件:Stochastic Exploration(对同一 prompt 采样多样化轨迹以比较相对优劣)与可计算的转移概率 $\log \pi_\theta(a_t \mid s_t)$(用于计算 Importance Ratio 与 KL 正则),而确定性 ODE 两者都不具备。
围绕这一核心矛盾,2025 至 2026 年的 Flow Matching RL 研究沿着四步清晰演进:
- 借助 ODE-to-SDE 转换,把 LLM 中的 GRPO(Group Relative Policy Optimization)引入连续流模型;
- 利用 Sliding Window 与 Trajectory Branching,压低全链路算力开销并解决 Temporal Credit Assignment;
- 通过 Forward-Process 优化(DiffusionNFT)与 Stochastic Optimal Control(Adjoint Matching / RAM),彻底摆脱逆向 SDE 似然追踪;
- 升级为把 Flow Matching 模型当作工具调用的多轮 Agentic RL 闭环推理系统。
下文由浅入深串起整条技术脉络:先夯实从 MDP 到 GRPO 家族的 RL 理论基础,再完整推导 Marginal-Preserving SDE 并剖析 PyTorch 核心实现,随后系统梳理 Flow-GRPO 方法族、Forward-Process / SOC 范式以及 Agentic RL 的最新进展。
Notation 约定(Lipman FM vs. SD3.5 / Flow-GRPO):在 Lipman 等人的原始 Flow Matching 文献中,通常设 $t=0$ 为噪声、$t=1$ 为真实数据($X_t = t X_1 + (1-t) X_0$);而在 Stable Diffusion 3.5、FLUX 及 Flow-GRPO 等面向 Rectified Flow 对齐的论文与代码库中,普遍沿用 Diffusion 方向约定——$t=1$ 为标准高斯噪声 $x_1 \sim \mathcal{N}(0, I)$,$t=0$ 为干净样本 $x_0 \sim q$: $$x_t = (1-t)x_0 + t x_1, \qquad v_t = \frac{dx_t}{dt} = x_1 - x_0.$$ 因此 Reverse-Time Generation 从 $t=1$ 积分至 $t=0$,离散时间步长 $\Delta t = t_{\text{prev}} - t \lt 0$。下文第 2 至第 4 节统一采用 SD3.5 / Flow-GRPO 约定,确保公式符号与 PyTorch 代码严格一一对应。
RL Foundations:从 MDP 到 GRPO
理解视觉生成中的 RL 算法,首先要看清为什么 Policy Optimization 会从早期需要 Critic 的 PPO 一路简化到 Critic-Free 的 GRPO,以及文本推理上的经验迁移到连续视觉轨迹时哪些假设会失效。
Denoising as an MDP
按照 DDPO[1] 确立的经典形式化框架,多步迭代去噪过程可以严格建模为有限视界 Markov Decision Process(MDP)$(\mathcal{S}, \mathcal{A}, \rho_0, P, R)$:
- State $s_t \triangleq (c, t, x_t)$:包含条件 prompt $c$、当前 timestep $t$ 以及带噪隐变量 $x_t$。
- Action $a_t \triangleq x_{t-1}$(连续调度器下记为 $x_{t+\Delta t}$):去噪网络在状态 $s_t$ 下采样出的下一步隐状态。
- Policy $\pi_\theta(a_t \mid s_t) \triangleq p_\theta(x_{t-1} \mid x_t, c)$:神经网络参数化的单步条件转移分布。
- Transition Kernel $P(s_{t+1} \mid s_t, a_t) \triangleq (\delta_c, \delta_{t-1}, \delta_{x_{t-1}})$:一旦动作 $a_t$ 采样完成,下一状态就是完全确定的 Dirac $\delta$ 分布。
- Initial Distribution $\rho_0(s_0) \triangleq (p(c), \delta_T, \mathcal{N}(0, I))$:prompt 抽自数据集分布,初始 latent 采自各向同性标准正态分布。
- Sparse Terminal Reward $R(s_t, a_t)$:仅在终点生成干净图像 $x_0$ 时给出奖励 $r(x_0, c)$,所有中间去噪步的即时奖励均为 $0$。
这一 MDP 建模直接点明了视觉生成 RL 的核心难度:所有中间步均无直接反馈,奖励信号(如人类偏好打分、OCR 准确率或 VLM Judge)只能在轨迹终点观测,使得长序列上的 Temporal Credit Assignment 极具挑战。
Policy Gradient 与 Importance Sampling
RL 的目标是最大化期望回报 $J(\pi_\theta) = \mathbb{E}_{\tau \sim \pi_\theta}[R(\tau)]$。利用 Log-Derivative Trick $\nabla_\theta P(\tau \mid \pi_\theta) = P(\tau \mid \pi_\theta)\nabla_\theta \log P(\tau \mid \pi_\theta)$ 展开轨迹概率 $P(\tau \mid \pi_\theta) = \rho_0(s_0)\prod_t P(s_{t+1}\mid s_t,a_t)\pi_\theta(a_t \mid s_t)$,与 $\theta$ 无关的初始分布和转移核在求导后消去,得到 Policy Gradient 基本形式:
$$\nabla_\theta J(\pi_\theta) = \mathbb{E}_{\tau \sim \pi_\theta}\!\left[\sum_{t} \big(R(\tau) - b(s_t)\big)\,\nabla_\theta \log \pi_\theta(a_t \mid s_t)\right]$$减去仅依赖状态的 Baseline $b(s_t)$ 保持梯度无偏(因为 $\mathbb{E}_{a_t \sim \pi_\theta}[b(s_t)\nabla_\theta \log\pi_\theta(a_t \mid s_t)] = 0$),同时显著压缩蒙特卡洛估计的方差。
然而在视觉生成中,采集一批 rollout 轨迹 $\tau$ 需要数十次十亿参数级 DiT 前向推理与昂贵的视觉 Reward 评估。如果每批样本只做一次梯度更新就丢弃,样本利用率极低。Importance Sampling 通过测度变换恒等式解决了这一瓶颈:
$$\mathbb{E}_{x \sim p}[f(x)] = \int f(x)\,\frac{p(x)}{q(x)}\,q(x)\,dx = \mathbb{E}_{x \sim q}\!\left[\frac{p(x)}{q(x)}\,f(x)\right]$$让旧策略 $\pi_{\theta_{\text{old}}}$ 充当采样分布 $q$,即可在缓存的 rollout batch 上连续执行多轮 mini-batch 更新,只需为每步梯度乘上 Importance Ratio $\rho_t(\theta) = \frac{\pi_\theta(a_t \mid s_t)}{\pi_{\text{old}}(a_t \mid s_t)}$。但一旦 $\pi_\theta$ 偏离 $\pi_{\text{old}}$ 过多,Importance Ratio 的方差会急剧膨胀并冲垮训练。如何以低方差估计 Advantage 并约束步长,正是 PPO 与 GRPO 的核心所在。
PPO、GAE 与 DPO
PPO[2] 从“降方差”和“控步长”双管齐下。一方面引入 Critic 网络 $V_\psi(s_t)$ 估计状态的平均未来回报,并基于单步 TD Error $\delta_t = r_t + \gamma V_\psi(s_{t+1}) - V_\psi(s_t)$ 构造 GAE(Generalized Advantage Estimation):
$$\widehat A_t^{\text{GAE}(\gamma, \lambda)} = \sum_{k=0}^{T-1-t} (\gamma\lambda)^k \delta_{t+k}, \qquad \widehat A_t = \delta_t + \gamma\lambda\,\widehat A_{t+1}$$衰减系数 $\lambda \in [0, 1]$ 平滑调节 Bias–Variance Tradeoff:$\lambda = 0$ 时退化为低方差但高偏差的单步 TD(0);$\lambda = 1$ 时退化为无偏但高方差的 Monte Carlo 回报(工程中通常取 $\lambda = 0.95$)。在 PyTorch 中,GAE 可通过一次逆向遍历算出:
with torch.no_grad():
    nextvalues = 0.0
    lastgaelam = 0.0
    advantages_reversed = []
    gen_len = token_level_rewards.shape[-1]

    for t in reversed(range(gen_len)):
        delta = token_level_rewards[:, t] + gamma * nextvalues - values[:, t]
        lastgaelam = delta + gamma * lam * lastgaelam
        # 若存在变长序列 mask,需在此处清零无效步的状态传递
        nextvalues = values[:, t]
        advantages_reversed.append(lastgaelam)

    advantages = torch.stack(advantages_reversed[::-1], dim=1)
    returns = advantages + values
另一方面,PPO 用 Clipping 将策略比率 $\rho_t(\theta)$ 限制在 $[1-\epsilon, 1+\epsilon]$ 内,将 Clipped Actor Loss、Clipped Value Loss、Entropy Bonus 与参考策略 KL Penalty 合为一体:
$$\mathcal{L}_{\text{PPO}}(\theta,\psi) = \mathbb{E}_{\tau \sim \pi_{\text{old}}}\!\left[\frac{1}{T}\sum_{t=0}^{T-1}\Big(-\min\big(\rho_t(\theta)\widehat A_t,\, \operatorname{clip}(\rho_t(\theta),1-\epsilon,1+\epsilon)\widehat A_t\big) + c_V \ell_t^{\text{value}}(\psi) - c_H \mathcal{H}(\pi_\theta) + \beta\,D_{\text{KL}}(\pi_\theta \,\|\, \pi_{\text{ref}})\Big)\right]$$PPO 的痛点在于系统代价过高——需同时维护 Actor、Critic、Reward Model 与 Reference Model 四个大模型;而在视觉生成中,让 Critic $V_\psi(x_t, t, c)$ 从高维带噪 latent $x_t$ 准确预测终局审美分数更是极其脆弱。
DPO[3] 另辟蹊径,绕开显式 Reward Model 与 Critic:KL-Regularized RL 目标 $\max_\pi \mathbb{E}[r(x,y)] - \beta D_{\text{KL}}(\pi \,\|\, \pi_{\text{ref}})$ 具有闭式最优解 $\pi^*(y \mid x) = \frac{1}{Z(x)}\pi_{\text{ref}}(y \mid x)\exp(r(x,y)/\beta)$。反解出奖励函数 $r(x,y) = \beta\log\frac{\pi^*(y\mid x)}{\pi_{\text{ref}}(y\mid x)} + \beta\log Z(x)$ 并代入 Bradley–Terry 偏好模型,配分函数 $Z(x)$ 恰好消去,得到纯监督形式的偏好对比损失:
$$\mathcal{L}_{\text{DPO}}(\theta) = -\mathbb{E}_{(x, y_w, y_l) \sim \mathcal{D}}\!\left[\log \sigma\!\left(\beta\log\frac{\pi_\theta(y_w \mid x)}{\pi_{\text{ref}}(y_w \mid x)} - \beta\log\frac{\pi_\theta(y_l \mid x)}{\pi_{\text{ref}}(y_l \mid x)}\right)\right]$$从数学本质看,DPO 求解的正是与 PPO RLHF 相同的优化目标,只是把“Online Rollout + 梯度上升”换成了“闭式解 + Offline Supervised Learning”(也正因仅约束相对差值,实操中需警惕正负样本概率同时下降的风险)。将这一思想迁移到扩散模型,Diffusion-DPO[4] 利用 Forward Process 的 ELBO 噪声预测 MSE 替代不可算的 $\log \pi_\theta(x_0 \mid c)$,在 Pick-a-Pic 等静态偏好对上实现了稳定对齐——但它依然受限于离线数据分布,无法像 Online RL 那样在策略演化中主动探索高奖励区域。
GRPO 及其 Post-R1 演进
GRPO(Group Relative Policy Optimization)[5] 保留了 Online Exploration 能力,同时彻底砍掉了 Value Critic。对同一 prompt $q$ 采样一组共 $G$ 条轨迹 $\{o_i\}_{i=1}^G$,获得结果奖励 $\mathbf{R} = (R_1, \dots, R_G)$ 后,直接以组内均值与标准差构造归一化相对优势,并广播给整条轨迹的每一步:
$$\widehat A_{i,t} = \widehat A_i = \frac{R_i - \operatorname{mean}(\mathbf{R})}{\operatorname{std}(\mathbf{R}) + \delta}$$结合步级重要性比率 $r_{i,t}(\theta) = \frac{\pi_\theta(a_{i,t} \mid s_{i,t})}{\pi_{\text{old}}(a_{i,t} \mid s_{i,t})}$ 与无偏低方差的参考 KL Penalty(工程上常采用 Schulman $k_3$ 估计 $\frac{\pi_{\text{ref}}}{\pi_\theta} - \log\frac{\pi_{\text{ref}}}{\pi_\theta} - 1$),完整 GRPO Loss 为:
$$\mathcal{L}_{\text{GRPO}}(\theta) = -\mathbb{E}_{q, \{o_i\}}\!\left[\frac{1}{G}\sum_{i=1}^G \frac{1}{|o_i|}\sum_{t=1}^{|o_i|} \min\!\Big(r_{i,t}(\theta)\widehat A_{i,t},\, \operatorname{clip}(r_{i,t}(\theta), 1-\epsilon, 1+\epsilon)\widehat A_{i,t}\Big)\right] + \beta\,\mathbb{E}_{i,t}\!\left[D_{\text{KL}}(\pi_\theta \,\|\, \pi_{\text{ref}})\right]$$# GRPO 组内相对优势计算(标准 GRPO 与去标准差版 Dr. GRPO)
scores = token_level_rewards.sum(dim=-1)
with torch.no_grad():
for i in range(bsz):
id2score[index[i]].append(scores[i])
for idx, vals in id2score.items():
t = torch.stack(vals)
id2mean[idx] = t.mean()
id2std[idx] = t.std()
for i in range(bsz):
if norm_adv_by_std_in_grpo:
scores[i] = (scores[i] - id2mean[index[i]]) / (id2std[index[i]] + eps)
else:
scores[i] = scores[i] - id2mean[index[i]] # Dr. GRPO 省略标准差归一化
advantages = scores.unsqueeze(-1) * response_maskDeepSeek-R1 之后,围绕 Long-CoT 的一系列后续工作迅速揭示了基础 GRPO 的几个结构性缺陷,而这些洞见几乎全部在后续 Flow Matching RL 中一一重现:
- MDPO(Kimi k1.5)[6] 从 Online Mirror Descent 导出更紧凑的代理目标:从当前策略 $\pi_{\theta_i}$ 采样轨迹 $(y, z)$,用组均值近似配分对数 $\tau\log Z(x) \approx \bar r$,直接让 $\tau\log\frac{\pi_\theta(y\mid x)}{\pi_{\theta_i}(y\mid x)}$ 回归到相对奖励 $r(x,y,y^*) - \bar r$。Kimi k1.5 同时指出,基于规则的 ORM(Outcome Reward)往往比 PRM(Process Reward)更容易催生“aha moment”,因为激进的 Value 惩罚会过早抹杀“差一点就对”的探索路径。
- DAPO[7] 在 32B 模型上针对 GRPO 痛点提出四项修复:
- Clip-Higher:非对称截断区间 $[1-\epsilon_{\text{low}}, 1+\epsilon_{\text{high}}]$,为低概率探索动作留出上浮空间,防止 Entropy Collapse;
- Dynamic Sampling:动态过滤全对或全错、组内方差为零的无效样本组;
- Token-Level Mean Loss:消除不同响应长度之间的梯度权重偏差;
- Soft Overlong Reward Shaping:对超长输出施加平滑长度惩罚。
- VAPO[8] 证明只要修复 Critic 训练瓶颈,Value-Based RL 依然能打平甚至超越 Critic-Free 路线——关键在于 Value-Pretraining、Decoupled-GAE(Critic 用 $\lambda=1.0$ 保持无偏回归,Actor 用 $\lambda=0.95$ 控制方差)、Length-Adaptive GAE、Clip-Higher 以及 Positive-Example LM Loss。
- GSPO[9] 指出逐 token 裁剪 $\rho_{i,t}$ 在长序列下存在长度敏感性与高方差噪声,改用长度归一化的 Sequence-Level 几何平均重要性比 $s_i(\theta) = \exp\!\big(\frac{1}{|y_i|}\sum_t \log r_{i,t}(\theta)\big)$,借助 Stop-Gradient 技巧即可将序列级比值无痛回传给每个 token。
- On-Policy Distillation(OPD)[10] 将 RL 的 On-Policy 状态分布与 SFT 的逐点密集监督结合起来:由学生模型 $\pi_\theta$ 自行采样轨迹,并在每一步向教师 $\nu$ 查询局部概率分布,按 Forward KL $D_{\text{KL}}(\nu \,\|\, \pi_\theta)$(偏 Mode-Covering,如 GKD)或 Reverse KL $D_{\text{KL}}(\pi_\theta \,\|\, \nu)$(偏 Mode-Seeking,如 PG-OPD)进行在线蒸馏。
| 范式 | Rollout 来源 | State Distribution | Feedback Density | 核心瓶颈 |
|---|---|---|---|---|
| SFT / Offline Distill | Teacher / 静态数据集 | Teacher trajectory | Dense(每步/每 token) | Exposure Bias:推理进入未见 state 后误差累积 |
| RL(PPO / GRPO) | Student self-rollout | On-policy student | Sparse(通常仅终端标量) | Credit Assignment 困难、高方差、样本利用率较低 |
| On-Policy Distillation | Student self-rollout | On-policy student | Dense(Teacher log-probs) | 需在线查询 Teacher 模型,系统开销偏高 |
上述 LLM-RL 的每一条经验都在后文有精准对应:
- DAPO 的 Clip-Higher 对应 GRPO-Guard 对连续比率漂移的抑制;
- 零方差样本组难题催生了 Pref-GRPO 的成对偏好胜率建模;
- Credit Assignment 难题直接驱动了 TempFlow-GRPO 与 BranchGRPO;
- 免反向概率比的在线密集监督正是 DiffusionNFT 的核心思想。
ODE-to-SDE:把 Online RL 引入 Flow Matching
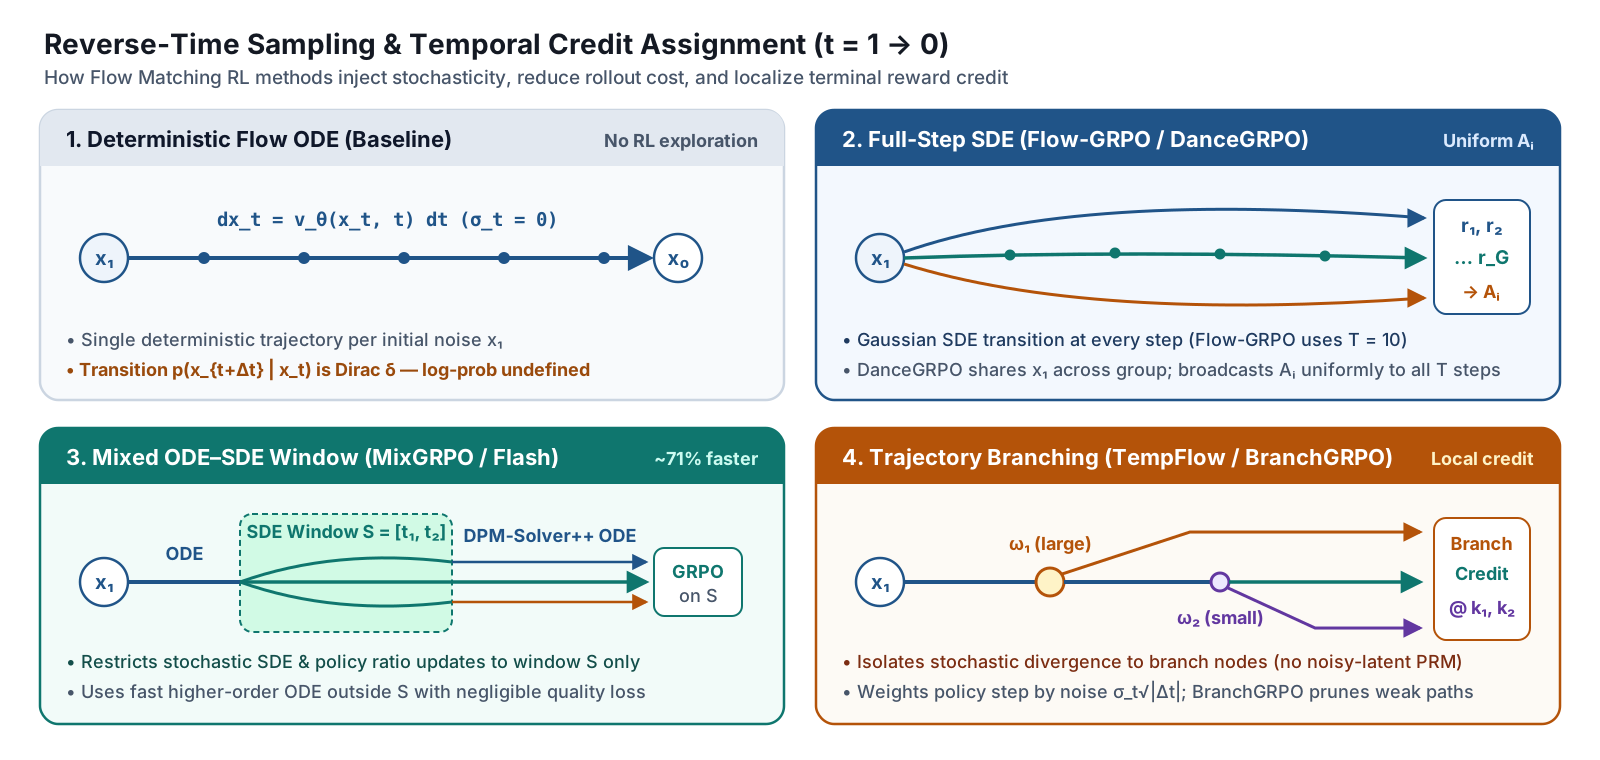
回到 Flow Matching:为什么不能直接拿预训练好的 Rectified Flow 跑 GRPO?因为其采样遵循确定性 Probability Flow ODE $dx_t = v_\theta(x_t, t, c)\,dt$(从 $t=1$ 到 $t=0$),给定初始高斯噪声 $x_1$ 后只能生成唯一一条固定轨迹,单步转移退化为 Dirac $\delta$ 分布 $p_\theta(x_{t+\Delta t} \mid x_t, c) = \delta(x_{t+\Delta t} - \Phi(x_t))$。这直接留下两个致命缺口:
- 缺乏随机探索:同一 prompt 配同一初始噪声下无法采样出多样化轨迹来对比相对优劣;
- 似然不可求:转移概率对数 $\log \pi_\theta$ 根本无法求值。
Marginal-Preserving SDE 推导
Flow-GRPO[12] 给出的破局方案十分优雅:将确定性 ODE 转换为在所有时刻 $t \in [0, 1]$ 上严格保持相同边际密度 $p_t(x)$ 的随机微分方程(SDE)[11]。推导过程可分为四步:
第一步:Forward Fokker–Planck 等价条件。 在正向加噪方向($t: 0 \to 1$),Flow ODE 满足 Continuity Equation $\partial_t p_t + \nabla\cdot(p_t v_t) = 0$。考察标准正向 Itô SDE:$dx_t = f_t^{\text{fwd}}(x_t)\,dt + \sigma_t\,dw_t$,其边际密度演化由 Fokker–Planck Equation 支配:
$$\frac{\partial p_t}{\partial t} + \nabla\cdot(p_t f_t^{\text{fwd}}) = \frac{1}{2}\sigma_t^2 \Delta p_t = \nabla\cdot\!\left(\frac{\sigma_t^2}{2}\nabla p_t\right) = \nabla\cdot\!\left(\frac{\sigma_t^2}{2}p_t\nabla\log p_t\right)$$令两式对 $\partial_t p_t$ 的演化完全一致,即 $\nabla\cdot(p_t v_t) = \nabla\cdot(p_t f_t^{\text{fwd}} - \frac{\sigma_t^2}{2}p_t\nabla\log p_t)$,解得正向 Marginal-Preserving Drift:$f_t^{\text{fwd}}(x_t) = v_t(x_t) + \frac{\sigma_t^2}{2}\nabla\log p_t(x_t)$。
第二步:Anderson Time-Reversal($t: 1 \to 0$)。 根据 Anderson 逆时 SDE 定理,将正向 SDE 反转用于生成采样时,Drift 需减去 $\sigma_t^2\nabla\log p_t(x_t)$,于是得到 Reverse-Time SDE:
$$dx_t = \Big(f_t^{\text{fwd}}(x_t) - \sigma_t^2 \nabla\log p_t(x_t)\Big)dt + \sigma_t\,d\bar w_t = \left[v_t(x_t) - \frac{\sigma_t^2}{2}\nabla\log p_t(x_t)\right]dt + \sigma_t\,d\bar w_t$$从物理直觉上看,逆向采样中 $dt \lt 0$,因此 $-\frac{\sigma_t^2}{2}\nabla\log p_t(x_t)\,dt$ 恰好沿 Score Function(对数概率密度梯度)方向拉回样本,抵消随机布朗运动 $\sigma_t\,d\bar w_t$ 带来的扩散发散。
第三步:用 Velocity Field 表示 Score Function。 在 Rectified Flow 线性插值 $x_t = (1-t)x_0 + t x_1$(其中 $x_1 \sim \mathcal{N}(0, I)$)下,条件分布 $p(x_t \mid x_0) = \mathcal{N}((1-t)x_0, t^2 I)$ 满足 Tweedie's Formula:$\nabla_{x_t}\log p(x_t \mid x_0) = -\frac{x_t - (1-t)x_0}{t^2} = -\frac{x_1}{t}$,取条件期望即得 $\nabla\log p_t(x_t) = -\frac{\mathbb{E}[x_1 \mid x_t]}{t}$。结合 $v_t(x_t) = \mathbb{E}[x_1 - x_0 \mid x_t]$ 与 $x_t = (1-t)\mathbb{E}[x_0 \mid x_t] + t\,\mathbb{E}[x_1 \mid x_t]$ 消去 $\mathbb{E}[x_0 \mid x_t]$,可得 $\mathbb{E}[x_1 \mid x_t] = x_t + (1-t)v_t(x_t)$,从而把抽象的 Score 直接转化为模型已预测的速度场:
$$\nabla \log p_t(x_t) = -\frac{1}{t}\Big(x_t + (1-t)v_t(x_t)\Big)$$第四步:Euler–Maruyama 离散化与 Closed-Form KL。 将 Score 关系代入 Reverse-Time SDE,并以负步长 $\Delta t = t_{\text{prev}} - t \lt 0$ 离散化,即得高斯策略转移 $\pi_\theta(x_{t+\Delta t} \mid x_t, c) = \mathcal{N}(\mu_\theta(x_t, t),\, \sigma_t^2 |\Delta t|\,I)$:
$$x_{t+\Delta t} = \underbrace{x_t + \left[v_\theta(x_t, t) + \frac{\sigma_t^2}{2t}\big(x_t + (1-t)v_\theta(x_t, t)\big)\right]\Delta t}_{\mu_\theta(x_t, t)} + \sigma_t\sqrt{|\Delta t|}\,\epsilon, \qquad \epsilon \sim \mathcal{N}(0, I)$$对均值项按 $x_t$ 与 $v_\theta(x_t, t)$ 合并整理,得到与代码完全吻合的形式:
$$\mu_\theta(x_t, t) = x_t\left(1 + \frac{\sigma_t^2}{2t}\Delta t\right) + v_\theta(x_t, t)\left(1 + \frac{\sigma_t^2(1-t)}{2t}\right)\Delta t$$取噪声调度 $\sigma_t = a\sqrt{\frac{t}{1-t}}$($a$ 为控制随机探索强度的标量超参数),由于 $\pi_\theta$ 与参考策略 $\pi_{\text{ref}}$ 共享完全相同的各向同性方差 $\sigma_t^2 |\Delta t| I$,两者单步 KL Divergence 退化为两个速度场预测差的加权 $L_2$ 范数,完全免去 Monte Carlo 估计:
$$D_{\text{KL}}(\pi_\theta \,\|\, \pi_{\text{ref}}) = \frac{\|\mu_\theta - \mu_{\text{ref}}\|^2}{2\sigma_t^2 |\Delta t|} = \frac{|\Delta t|}{2}\left(\frac{1}{\sigma_t} + \frac{\sigma_t(1-t)}{2t}\right)^2 \|v_\theta(x_t, t) - v_{\text{ref}}(x_t, t)\|^2$$PyTorch 实现:sde_step_with_logprob
在官方 yifan123/flow_grpo 代码库中,整个 ODE-to-SDE 转换被封装在一个兼顾“Rollout 采样”与“Policy Update 重算 log-prob”的函数 sde_step_with_logprob 中:
def sde_step_with_logprob(
    self,
    model_output: torch.FloatTensor,   # 网络预测速度场 v_theta(x_t, t, c)
    timestep: Union[float, torch.Tensor],
    sample: torch.FloatTensor,         # 当前时刻 latent x_t
    noise_level: float = 0.7,
    prev_sample: Optional[torch.FloatTensor] = None,
    generator: Optional[torch.Generator] = None,
):
    model_output = model_output.float()
    sample = sample.float()
    if prev_sample is not None:
        prev_sample = prev_sample.float()

    # 将离散 scheduler timestep 映射到连续 sigma 区间 [0, 1]
    step_index = [self.index_for_timestep(t) for t in timestep]
    prev_step_index = [step + 1 for step in step_index]
    sigma = self.sigmas[step_index].view(-1, *([1] * (sample.ndim - 1)))
    sigma_prev = self.sigmas[prev_step_index].view(-1, *([1] * (sample.ndim - 1)))
    sigma_max = self.sigmas[1].item()  # 防止起点 sigma == 1 时 1 / (1 - sigma) 奇异

    dt = sigma_prev - sigma  # 逆向去噪过程中严格为负 (1 -> 0)
    std_dev_t = torch.sqrt(sigma / (1 - torch.where(sigma == 1, sigma_max, sigma))) * noise_level

    # Marginal-Preserving SDE 的条件高斯均值: mu_theta(x_t, t)
    prev_sample_mean = (
        sample * (1 + std_dev_t**2 / (2 * sigma) * dt)
        + model_output * (1 + std_dev_t**2 * (1 - sigma) / (2 * sigma)) * dt
    )

    # 分支 1(Rollout 阶段): 采样下一步 latent; 分支 2(Update 阶段): 评估缓存动作的 log_prob
    if prev_sample is None:
        variance_noise = randn_tensor(
            model_output.shape, generator=generator, device=model_output.device, dtype=model_output.dtype
        )
        prev_sample = prev_sample_mean + std_dev_t * torch.sqrt(-1 * dt) * variance_noise

    # 各向同性高斯转移 log-prob(在空间与通道维度取 mean 以稳定 importance ratio)
    step_std = std_dev_t * torch.sqrt(-1 * dt)
    log_prob = (
        -((prev_sample.detach() - prev_sample_mean) ** 2) / (2 * (step_std**2))
        - torch.log(step_std)
        - torch.log(torch.sqrt(2 * torch.as_tensor(math.pi, device=sample.device)))
    )
    log_prob = log_prob.mean(dim=tuple(range(1, log_prob.ndim)))
    return prev_sample, log_prob, prev_sample_mean, std_dev_t
这段核心实现里有四个直接决定训练稳定性的工程细节:
dt的正负号处理:逆向调度时sigma_prev < sigma,dt本身是负数,因此在 Drift 均值中直接乘以有符号dt推动样本去噪,而在计算扩散标准差时必须取torch.sqrt(-1 * dt)(即 $\sqrt{|\Delta t|}$)。- 终点奇异性保护:第一步时 $t = \sigma = 1$,$\sqrt{\sigma/(1-\sigma)}$ 分母为零;通过
torch.where(sigma == 1, sigma_max, sigma)将首步分母安全钳位到次大网格点sigmas[1]。 - Action 截断梯度(
prev_sample.detach()):在策略更新阶段,已经执行过的动作prev_sample从 buffer 取出,梯度仅通过prev_sample_mean(即 $v_\theta$)反向传播。 - 隐空间维度取
mean而非sum:若直接对 $(C, H, W)$ 数万维坐标求和,微小的均值漂移都会被放大成极端的 $\exp(\log\pi_\theta - \log\pi_{\text{old}})$,导致全步瞬间触发 PPO Clip;按维度取均值是高分辨率 DiT 上 Ratio 稳定的关键保障。
Reverse-Process Flow-GRPO 方法族
有了 sde_step_with_logprob 作为基本原语,围绕“如何加速采样、如何精准分配 Temporal Credit、如何防止 Reward Hacking”这一系列核心问题,Reverse-Process Flow-GRPO 方法族迅速演化出多个关键分支。
Flow-GRPO 与 DanceGRPO:Online RL 基线
Flow-GRPO[12] 在提出 ODE-to-SDE 转换的同时,引入了一项极为实用的加速策略——Denoising Reduction:训练 rollout 阶段仅跑 $T=10$ 步粗糙 SDE 收集轨迹,虽单图画质略低于推理配置,却已足以准确排序各轨迹的奖励相对高低;等到测试推理时再恢复为 $T=40$ 步 Deterministic ODE 采样,兼顾了训练吞吐与最终生成精度。配合上述 Closed-Form KL 正则防止过拟合,Flow-GRPO 在 SD3.5 上的组合构图(GenEval)、视觉文字渲染(OCR)与人类偏好指标均取得了大幅跃升。
DanceGRPO[13] 则将同一套 SDE-MDP 范式统一推广至 Diffusion 与 Rectified Flow 两大流派,覆盖 Stable Diffusion 1.4、FLUX、HunyuanVideo 与 SkyReels-I2V 等图文/视频生成底座(T2I、T2V、I2V)。其标准 Clipped Objective 对组内 $G$ 条轨迹与 $T$ 个 timestep 联合求平均:
$$J_{\text{DanceGRPO}}(\theta) = \mathbb{E}_{\{o_i\}_{i=1}^G \sim \pi_{\theta_{\text{old}}}}\!\left[\frac{1}{G}\sum_{i=1}^G \frac{1}{T}\sum_{t=1}^T \min\!\Big(\rho_{i,t}(\theta)\widehat A_i,\, \operatorname{clip}(\rho_{i,t}(\theta), 1-\epsilon, 1+\epsilon)\widehat A_i\Big)\right]$$在工程实践层面,DanceGRPO 总结了四条直接决定视觉 RL 稳定性的经验法则:
- Shared Initial Noise:早期的 Diffusion RL(如 DDPO)为每条样本独立采样初始噪声 $x_1$;DanceGRPO 发现将同一 prompt 组内的 $G$ 条轨迹全部绑定到同一个初始噪声 $x_1$,可以让奖励差异完全来自中间 SDE 探索而非“初始种子运气”,显著降低梯度方差。
- Timestep Subsampling:去噪轨迹中不必对所有步数都做反向更新,随机或间隔抽取部分 timestep 即可在不掉点的情况下大幅降低显存与计算开销。
- Multi-Reward Ensemble 防 Hacking:单独优化美学分数(如 HPS-v2.1)极易导致画面过度饱和、呈现不自然的“油腻感”;将 HPS-v2.1 与 CLIP 图文对齐分数联合加权,能有效守住真实纹理与语义约束。
- 省略 KL 与 Best-of-$N$ 对齐:在共享噪声与多奖励约束下,DanceGRPO 验证即使移除显式 KL Penalty 也未出现崩溃,反而提升了最终对齐上限;配合 Best-of-$N$ 候选筛选可进一步放大高奖励路径的收益。
MixGRPO、TempFlow-GRPO 与 BranchGRPO:效率与 Temporal Credit Assignment
尽管 Flow-GRPO 与 DanceGRPO 跑通了 Online RL 闭环,Full-Trajectory SDE 优化仍存在两大固有短板:
- 全链条算力开销大:新旧策略必须对全部 $T$ 个去噪步逐一重算后验转移概率。
- Temporal Uniformity Assumption:把唯一的终端奖励均等地摊给所有时间步,忽视了早期高噪阶段决定宏观构图与物体布局、后期低噪阶段只负责细节润色的物理事实。
MixGRPO[14] 直击算力瓶颈,提出 Mixed ODE–SDE Sliding Window:只在沿去噪时间移动的局部窗口 $S = [t_1, t_2]$ 内使用随机 SDE 采样并计算 GRPO 梯度,窗口之外全部切换为确定性 ODE 采样:
$$dx_t = \begin{cases} \left[v_\theta(x_t, t) - \frac{\sigma_t^2}{2}\nabla\log p_t(x_t)\right]dt + \sigma_t\,d\bar w_t, & t \in S \\ v_\theta(x_t, t)\,dt, & t \notin S \end{cases}$$窗口外的 ODE 步骤彻底免除了后验 log-prob 计算;MixGRPO-Flash 进一步在窗口外启用高阶 Solver(如 DPM-Solver++),在不损伤 HPS-v2.1、PickScore、ImageReward 与 UnifiedReward 指标的前提下,将整体训练时间压缩约 71%。
TempFlow-GRPO[15] 则正面对抗 Temporal Uniformity Assumption,引入两项精细的时间感知机制:
- Trajectory Branching:由于半去噪中间态 $x_t$ 充满噪声、语义模糊,专门训练视觉 PRM 极其困难。TempFlow-GRPO 巧妙利用 ODE–SDE 切换取代 PRM:从起点到选定分支步 $k$ 全程走确定性 ODE,仅在时刻 $k$ 注入随机 SDE 噪声分化出多个分支 $x_{k+\Delta t} = \text{SDE}(x_k, \epsilon)$,随后各分支再走回确定性 ODE 抵达终点 $x_0$。根据 Credit Localization 定理,各分支最终奖励的方差严格且唯一地归因于步 $k$ 的探索动作,无需修改任何奖励模型即实现了精确的 Process Credit 归因。
- Noise-Aware Policy Weighting:实证显示终端奖励方差在早期高噪步达到峰值并随后单调递减,而这恰与 SDE 扩散步长 $\sigma_t\sqrt{|\Delta t|}$ 的变化曲线高度同频。因此 TempFlow-GRPO 直接用当前步的归一化噪声强度对策略损失加权:
高噪声早期获得更大梯度权重以鼓励宏观结构探索,低噪声后期维持温和微调以保护精细纹理。
沿同一思路继续扩展,BranchGRPO[16] 将单点分叉推广为共享确定性前缀的结构化 Branching Tree:不仅在关键深度按父节点相对优势精细分配信用,还能在生成中途提前剪枝低收益分支,将整体训练耗时进一步降低约 55%。
稳定性改进:Pref-GRPO、GRPO-Guard 与 Flow-CPS
在工程落地中,围绕统计稳定性与采样器离散误差的几项后续改进同样非常关键:
- Pref-GRPO[17] 指出 Pointwise Reward Model 往往对品质接近的组内样本给出极其相近的标量分,经 $\operatorname{std}(\mathbf{R})$ 归一化后微小的打分噪声会被急剧放大并诱发 Reward Hacking;改用 Pairwise Preference Reward Model(PPRM)并以组内胜率计算优势,可大幅稳定文生图 RL。
- GRPO-Guard[18] 深入剖析了 FLUX.1-dev 与 SD3.5-M 上 Importance Ratio 随 timestep 发生的隐式分布偏移,提出 Regulated Clipping(按时间步调节的裁剪边界),从机制上呼应了 LLM 中 DAPO 的 Clip-Higher 思想。
- Flow-CPS[19] 则针对采样器离散误差本身,以 Coefficients-Preserving Sampling 取代粗糙的 Euler–Maruyama 近似,在低步数下更稳定地保持 SDE 边际统计特性。
Beyond Reverse-SDE:Forward-Process、SOC 与 Control Policies
无论引入 Sliding Window 还是 Branching Tree,Reverse-SDE 路线始终离不开离散高斯转移假设、特定采样器绑定以及沿采样链保存隐状态的开销。2025 年底至 2026 年的另一股强力范式革新直指核心问题:RL 微调一定要在 Reverse-SDE 上计算转移概率吗?
DiffusionNFT:基于 Forward Process 的 Online RL
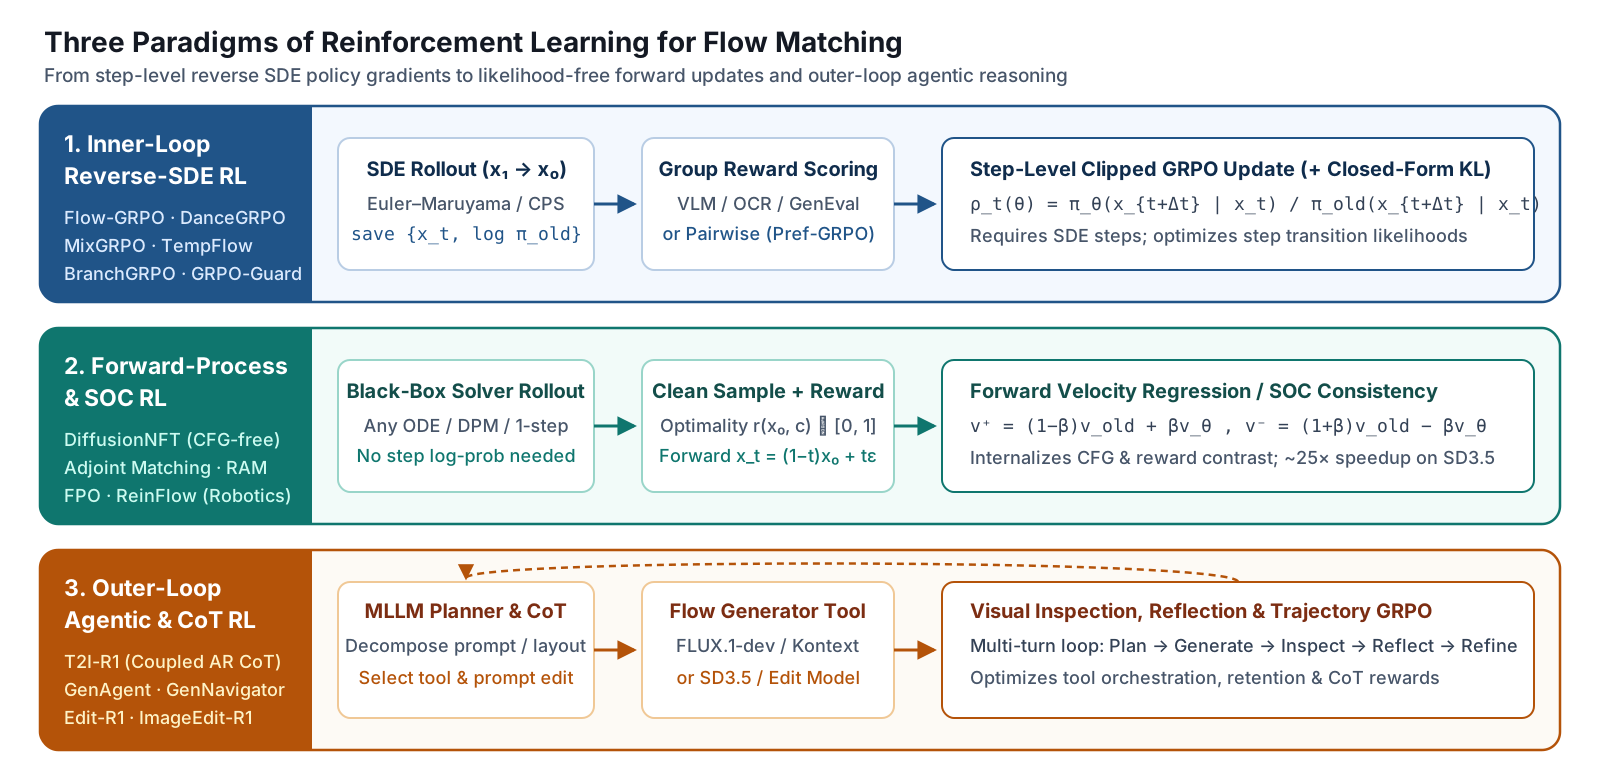
DiffusionNFT[20] 彻底跳出了逆向采样链。传统 Rejection Sampling Fine-Tuning(RFT)只保留高分图像、丢弃负样本,不仅浪费一半 rollout 算力,还容易因为缺乏负向推力而陷入 Reward Collapse。DiffusionNFT 允许使用任意 Black-Box Solver(高阶 ODE、少步蒸馏器乃至无 CFG 采样)生成干净图像 $x_0$ 并评估归一化最优性奖励 $r(x_0, c) \in [0, 1]$,随后直接把训练拉回标准 Flow Matching 的 Forward Process 插值 $x_t = (1-t)x_0 + t\epsilon$(目标速度为 $\epsilon - x_0$)。
其核心是围绕旧策略 $v^{\text{old}}$ 构造一对 Implicit Parameterization 正负速度场($\beta \gt 0$ 为更新强度):
$$v_\theta^+(x_t, t, c) = (1 - \beta)\,v^{\text{old}}(x_t, t, c) + \beta\,v_\theta(x_t, t, c), \qquad v_\theta^-(x_t, t, c) = (1 + \beta)\,v^{\text{old}}(x_t, t, c) - \beta\,v_\theta(x_t, t, c)$$并最小化如下 Negative-Aware Forward Regression 损失:
$$\mathcal{L}_{\text{NFT}}(\theta) = \mathbb{E}_{(x_0, c) \sim \pi_{\text{old}},\, t,\, \epsilon}\!\left[r(x_0, c)\,\big\|v_\theta^+(x_t, t, c) - (\epsilon - x_0)\big\|^2 + \big(1 - r(x_0, c)\big)\,\big\|v_\theta^-(x_t, t, c) - (\epsilon - x_0)\big\|^2\right]$$展开差值即可看到一个深刻的数学同构:$v_\theta^+ - v_\theta^- = 2\beta(v_\theta - v^{\text{old}})$。这在代数形式上与 Classifier-Free Guidance(CFG)完全同构——传统 CFG 在推理时以双倍前向开销放大“有条件与无条件”之差,而 DiffusionNFT 在 RL 训练中放大“高奖励与低奖励”之差,将引导能力直接内化进单一的 CFG-Free 网络权重中。
由于免除了逆向 log-prob 追踪与前反向离散化失配,DiffusionNFT 在 SD3.5-Medium 上实现了高达 Flow-GRPO $25\times$ 的收敛提速,约 1k 步即把 GenEval 从 $0.24$ 推升至 $0.98$。其两阶段、五种奖励的课程训练(curriculum)也十分清晰:
- Stage 1(Model-Based Preference):在 Pick-a-Pic 上联合优化 PickScore、CLIPScore 与 HPSv2.1,先稳固画面审美与基本图文匹配。
- Stage 2(Rule-Based Verifiers):叠加入 GenEval 与 OCR 硬规则奖励,在保住美学质感的同时大幅拉升复杂指令遵循与文字书写精度。
Stochastic Optimal Control 与 Embodied Flow Policies
与 DiffusionNFT 几乎平行,Stochastic Optimal Control(SOC)以及机器人 Embodied Flow Policies 两条路线也各自收敛到了“噪声注入”与“Forward-Loss Surrogate”的同一组数学原语上:
- Adjoint Matching:将 KL-Regularized Flow Fine-Tuning 刻画为 Memoryless SOC 问题[21],只需拟合 Adjoint ODE 的最优性条件而无需贯穿整条采样链反传,但原版仍依赖可微奖励梯度 $\nabla_{x_0} r(x_0)$。
- Reinforce Adjoint Matching(RAM):把伴随匹配的最优性条件与 REINFORCE 恒等式结合[22],导出无需伴随反向扫描、也无需计算 SDE Importance Ratio 的纯回归 Consistency Loss,将 SOC RL 直接扩展到不可微的 VLM 与 OCR 奖励。
- ReinFlow(Embodied Flow RL):向机器人确定性 Rectified Flow / Shortcut 动作策略注入可学习噪声网络[23],将其化为可求精确转移似然的离散马尔可夫链,与视觉中的 Flow-GRPO 思路一一对应。
- FPO(Flow Policy Optimization):完全跳过精确似然[24],直接利用 Conditional Flow Matching(CFM)ELBO 损失构造 PPO-clip 代理比率,以纯前向方式让机械臂策略从零学会多模态分布,与 DiffusionNFT 构成镜像。
从 Single-Pass Denoising 到 Reasoning 与 Agentic RL
前两节讨论的所有算法均作用于单次前向去噪的 Inner-Loop RL。然而,面对包含复杂空间约束、多物体计数与属性绑定的生成指令,或者需要反复局部修改的多步 Image Editing 任务,单靠一轮 28 步速度场积分很难不经规划与自检就一步到位。于是,结合显式 CoT 与多轮智能体闭环的 Agentic RL 成了补齐 Flow Matching 推理上限的新方向。
Coupled Reasoning & Generation:T2I-R1 与 Autoregressive CoT
T2I-R1[25] 最早把 R1 式的强化推理引入统一多模态自回归模型(基于 Janus-Pro),借助 BiCoT-GRPO 联合优化双层思维链:
- Semantic-level CoT:先用 GPT-4o 构造推理轨迹冷启动,使模型在生图前先用文本规划画面构图、空间关系与细节属性。
- Token-level CoT:随后沿用 Autoregressive Model 逐 token 预测图像 patch 的生成方式,在单次前向推理中完成渲染。
整个 rollout 过程同时接受四类异构 Reward Model(HPM 美学模型 HPS/ImageReward、Object Detector GroundingDINO/YOLO-World、VQA 模型 LLaVA 以及微调后的 LLaVA-OneVision ORM)的联合打分,并以此驱动 GRPO 更新。同期的 ReasonGen-R1[26] 与 GoT-R1[27] 也遵循这种在同一自回归策略内耦合 SFT 规划与 GRPO 对齐的路线。
但从架构本质来看,把自回归图像逐 token 解码包装成“Token-level CoT”虽然能顺滑复用文本 RL 基础设施,离散自回归生成器的画质、排版精度与局部物理一致性依然普遍逊于 FLUX、SD3.5 这类连续 Flow Matching DiT。自然而然地,研究者开始思考:如何在保留连续 Flow Matching 高质量渲染底座的同时,为其赋予多轮推理、视觉自检与纠错能力?
面向 Flow Matching 的 Agentic RL
不同于把理解与像素强行塞进同一个离散词表,面向 Flow Matching 的 Agentic RL 选择了“认知与渲染解耦”——将连续 Flow Matching 生成与编辑模型作为智能体在多轮闭环 MDP 中按需调用的工具:
- GenAgent(多轮 Tool-Use):将复杂文生图构建为“Plan → Generate → Inspect → Reflect → Refine”的多轮智能体轨迹[28]:MLLM 核心决策器反复调用现成的 FLUX.1-dev 生成或编辑工具,并在查看中间成图后自主排查漏画物体或错误属性绑定,采用冷启动轨迹 SFT 接轨轨迹级 Agentic RL。
- Generation Navigator(PRE-GRPO):将多轮迭代生成形式化为 State-Conditioned MDP[29],提出轨迹级 PRE-GRPO,端到端权衡最终图像峰值质量、跨轮次语义保持度与交互步数预算。
- UniWorld-V2 / Edit-R1(CoT Reward Editing):在指令编辑任务(如 FLUX.1-Kontext)中针对标量打分易漏幻觉的问题[30],引入带 CoT 的 Reasoning Reward Model(RRM)拆解视觉核验项,并用 DiffusionNFT 直接微调流编辑底座。
- ImageEdit-R1(Multi-Agent Planner):用 GRPO 训练多智能体编排器[31],把复合编辑指令拆解为有序的原子编辑步骤后交由底层流模型执行。
- Reflect-DiT(In-Context 自我反思):处于内外循环交界处,为 Diffusion Transformer 直接引入历史生成样本与 VLM 文本反馈作为 In-Context 条件[32],在推理期系统性迭代修复,显著超越 Best-of-$N$ 盲搜。
由此可以看到 Inner-Loop 与 Outer-Loop 的清晰分工:Inner-Loop RL(Flow-GRPO、DiffusionNFT、RAM)负责拔高 Flow Matching 单次前向去噪的物理执行上限;Outer-Loop Agentic RL(GenAgent、Generation Navigator、ImageEdit-R1)则负责复杂任务的拆解规划、工具调度、视觉核验与多轮纠错,两者叠加正成为高性能多模态生成的标准范式。
方法全景对比与选型建议
下表从 Paradigm、Solver Freedom、Credit Granularity、KL / CFG 机制与 Best Fit 五个维度,对代表性方案做一横向汇总:
| Method | Paradigm | Solver Freedom | Credit Granularity | KL / CFG 处理 | Best Fit |
|---|---|---|---|---|---|
Flow-GRPO |
Reverse-SDE GRPO | Euler SDE(训练 $T=10$) | 全部 $T$ 步均匀分摊 | Closed-form velocity KL | SD3.5 通用 Online RL 对齐基线 |
DanceGRPO |
Unified SDE GRPO | Euler SDE + 共享 $x_1$ | Subsampled steps、均匀 $A_i$ | 省略 KL;Multi-Reward | 大规模 T2I / T2V / I2V(FLUX、HunyuanVideo) |
MixGRPO / Flash |
Mixed ODE–SDE Window | 窗内 SDE + 窗外 DPM++ | 局限在 Sliding Window $S$ 内 | 窗口内 Clipped GRPO | 大幅削减 Reverse-SDE 训练耗时(约省 71%) |
TempFlow-GRPO |
Branching + Noise Weight | ODE + 单步 SDE Branch | 精确分支点 + $\sigma_t\sqrt{|\Delta t|}$ | Noise-aware clipped GRPO | 区分早期构图探索与后期细节微调 |
BranchGRPO |
Prefix-Tree Branching | Shared-prefix tree SDE | Parent-relative tree edges | 低收益分枝剪枝 + GRPO | 高吞吐路径探索(约省 55% 算力) |
Pref-GRPO / Guard |
Stabilized SDE GRPO | Reverse SDE | Pairwise 胜率 / Regulated Clipping | Regulated Clipping | 抑制 FLUX / SD3.5 上的 Reward Hacking 与崩溃 |
DiffusionNFT |
Forward-Process Contrast | 任意 Black-Box Solver | Forward FM 直接回归 | CFG-Free($v^+, v^-$ 内化) | 最高性价比单轮对齐(比 Flow-GRPO 快 ~25×) |
RAM |
SOC Consistency | 任意 Sampler | Adjoint–REINFORCE 一致性 | 目标内置 KL 约束 | 不可微 VLM Reward 且免伴随反向扫描 |
T2I-R1 |
Coupled AR CoT GRPO | Autoregressive tokens | Semantic + Token BiCoT | 四类专家奖励联合打分 | 需要图文一体 CoT 的统一离散多模态模型 |
GenAgent / Edit-R1 |
Outer-Loop Agentic RL | 调用 FLUX / Flow DiT | Multi-turn trajectory + CoT RRM | Trajectory RL / Tool Verify | 复杂空间布局规划与多步指令 Image Editing |
在工程选型上,可遵循以下四条实战准则:
- 算力预算敏感的单轮对齐优先选 Forward-Process 或 Hybrid Window:若核心诉求是快速把现有 T2I 底座对齐到偏好或 Rule-Based Verifiers,DiffusionNFT(兼得推理 CFG-Free 红利)与 MixGRPO-Flash 的性价比最高。
- 区分宏观构图与微观细节的学习节奏:遇到 Full-Step SDE 破坏高频细节或收敛缓慢时,优先采用 TempFlow-GRPO 的 Noise-Aware Weighting 或 BranchGRPO 的共享前缀分叉树,把主要梯度预算倾斜给早期高噪探索步。
- 尽早布防 Reward Hacking:组内尽量共享初始噪声 $x_1$(DanceGRPO),并将美学模型与 OCR / GenEval 等硬规则检出器组合使用;一旦发现分数虚高而画质下滑,立刻引入 Pref-GRPO 的成对胜率或 GRPO-Guard 的比率调节裁剪。
- 复杂组合推理交给 Outer-Loop Agentic RL:当瓶颈出在多物体空间规划、遗漏属性或复合编辑顺序时,不要强求单轮速度场独自消化所有逻辑——用 GenAgent、Generation Navigator 或 ImageEdit-R1 在 Flow Matching 外围套一层“Plan–Generate–Inspect–Refine”的智能体闭环往往立竿见影。
引用本文
如果本文的整理或图示对你有帮助,欢迎引用:
Chaoran Feng (2026). "Reinforcement Learning in Flow Matching Models". Chaoran Feng's Blog. https://www.falcary.com/blogs/flow-matching-rl/
@article{feng2026flowrl,
  title   = {Reinforcement Learning in Flow Matching Models},
  author  = {Feng, Chaoran},
  year    = {2026},
  month   = {September},
  url     = {https://www.falcary.com/blogs/flow-matching-rl/}
}
参考文献
- Training Diffusion Models with Reinforcement Learning. Black, Janner, Du, Kostrikov, Levine, ICLR 2024 (arXiv:2305.13301).
- Proximal Policy Optimization Algorithms. Schulman, Wolski, Dhariwal, Radford, Klimov, 2017 (arXiv:1707.06347).
- Direct Preference Optimization: Your Language Model is Secretly a Reward Model. Rafailov, Sharma, Mitchell, Ermon, Manning, Finn, NeurIPS 2023 (arXiv:2305.18290).
- Diffusion Model Alignment Using Direct Preference Optimization. Wallace, Dang, Rafailov, Zhou, Lou, Purushwalkam, Ermon, Xiong, Joty, Naik, CVPR 2024 (arXiv:2311.12908).
- DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models. Shao, Wang, Zhu, Xu, Song, Bi, Zhang, Zhang, Li, Wu, Guo, 2024 (arXiv:2402.03300).
- Kimi k1.5: Scaling Reinforcement Learning with LLMs. Kimi Team, 2025 (arXiv:2501.12599).
- DAPO: An Open-Source LLM Reinforcement Learning System at Scale. Yu, Zhang, Zhu, Yuan, Zuo, Yue, et al., 2025 (arXiv:2503.14476).
- VAPO: Efficient and Reliable Reinforcement Learning for Advanced Reasoning Tasks. Yue, Yuan, Yu, Zuo, Zhu, Xu, et al., 2025 (arXiv:2504.05118).
- Group Sequence Policy Optimization. Zheng, Liu, Li, Chen, Yu, Gao, et al. (Qwen Team), 2025 (arXiv:2507.18071).
- On-Policy Distillation of Language Models: Learning from Self-Generated Mistakes. Agarwal, Vieillard, Stańczyk, Ramos, Geist, Bachem, ICLR 2024 (arXiv:2306.13649).
- Score-Based Generative Modeling through Stochastic Differential Equations. Song, Sohl-Dickstein, Kingma, Kumar, Ermon, Poole, ICLR 2021 (arXiv:2011.13456).
- Flow-GRPO: Training Flow Matching Models via Online RL. Liu, Liu, Liang, Li, Liu, Wang, Wan, Zhang, Ouyang, NeurIPS 2025 (arXiv:2505.05470).
- DanceGRPO: Unleashing GRPO on Visual Generation. Xue, Wu, Gao, Kong, Zhu, Chen, Liu, Liu, Guo, Huang, Luo, 2025 (arXiv:2505.07818).
- MixGRPO: Unlocking Flow-based GRPO Efficiency with Mixed ODE-SDE. Li, Cui, Huang, Ma, Fan, Yang, Zhong, ECCV 2026 (arXiv:2507.21802).
- TempFlow-GRPO: When Timing Matters for GRPO in Flow Models. He, Fu, Zhao, Li, Yang, Yin, Rao, Zhang, 2025 (arXiv:2508.04324).
- BranchGRPO: Stable and Efficient GRPO with Structured Branching in Diffusion Models. Li, Wang, Zhu, Zhao, Lu, She, Zhang, ICLR 2026 (arXiv:2509.06040).
- Pref-GRPO: Pairwise Preference Reward-based GRPO for Stable Text-to-Image Reinforcement Learning. Wang, Li, Zang, Zhou, Bu, Wang, Lu, Jin, Wang, 2025 (arXiv:2508.20751).
- GRPO-Guard: Mitigating Implicit Over-Optimization in Flow Matching via Regulated Clipping. Wang, Liang, Liu, Liu, Liu, Zheng, Pang, Ma, Xie, Wang, Wang, Wan, Liang, 2025 (arXiv:2510.22319).
- Coefficients-Preserving Sampling for Reinforcement Learning with Flow Matching. Wang, Yu, 2025 (arXiv:2509.05952).
- DiffusionNFT: Online Diffusion Reinforcement with Forward Process. Zheng, Chen, Ye, Wang, Zhang, Jiang, Su, Ermon, Zhu, Liu, ICLR 2026 Oral (arXiv:2509.16117).
- Adjoint Matching: Fine-tuning Flow and Diffusion Generative Models with Memoryless Stochastic Optimal Control. Domingo-Enrich, Drozdzal, Karrer, Chen, ICLR 2025 (arXiv:2409.08861).
- Reinforce Adjoint Matching: Scaling RL Post-Training of Diffusion and Flow-Matching Models. Bergmeister, Jegelka, Nüsken, Domingo-Enrich, Pidstrigach, 2026 (arXiv:2605.10759).
- ReinFlow: Fine-tuning Flow Matching Policy with Online Reinforcement Learning. Zhang, Yu, Su, Wang, NeurIPS 2025 (arXiv:2505.22094).
- Flow Matching Policy Gradients. McAllister, Ge, Yi, Kim, Weber, Choi, Feng, Kanazawa, 2025 (arXiv:2507.21053).
- T2I-R1: Reinforcing Image Generation with Collaborative Semantic-level and Token-level CoT. Jiang, Guo, Zhang, Zong, Li, Zhuo, Yan, Heng, Li, 2025 (arXiv:2505.00703).
- ReasonGen-R1: CoT for Autoregressive Image Generation Models through SFT and RL. Zhang, Li, Yang, Wang, Yang, Qi, Bao, Chen, Luo, Qiu, 2025 (arXiv:2505.24875).
- GoT-R1: Unleashing Reasoning Capability of Autoregressive Visual Generation with Reinforcement Learning. Duan, Fang, Wang, Wang, Huang, Zeng, Li, Liu, 2025 (arXiv:2505.17022).
- GenAgent: Scaling Text-to-Image Generation via Agentic Multimodal Reasoning. Jiang, Wang, Zhou, Li, Liu, Xie, Chen, Zheng, Zhang, ECCV 2026 (arXiv:2601.18543).
- Generation Navigator: A State-Aware Agentic Framework for Image Generation. Liu, Feng, Wang, Zeng, Jin, 2026 (arXiv:2605.17969).
- UniWorld-V2: Reinforce Image Editing with Diffusion Negative-aware Finetuning and MLLM Implicit Feedback. Li, Liu, Zhang, Lin, Wu, Yuan, Yan, Ye, Yu, Niu, Wang, Cheng, Yuan, 2025 (arXiv:2510.16888).
- ImageEdit-R1: Boosting Multi-Agent Image Editing via Reinforcement Learning. Zhao, Ye, Liu, Shieh, Bui, 2026 (arXiv:2603.08059).
- Reflect-DiT: Inference-Time Scaling for Text-to-Image Diffusion Transformers via In-Context Reflection. Li, Kallidromitis, Gokul, Koneru, Kato, Kozuka, Grover, 2025 (arXiv:2503.12271).