Looped Transformer 通过重复执行同一段共享层,把“执行深度”与“静态参数量”拆开[6][7]。过去很多评测只在相同静态参数量下做对比,无形中让循环模型多花了成倍的 FLOPs 和 KV cache,很难分辨收益究竟来自结构本身还是额外算力。
2026 年的五项核心工作分别在语言模型与视觉生成领域把这条技术链条拼完整了:
- 语言模型侧:SMELT[1] 在单 token FLOPs、总参数量和 KV cache 三项预算同时对齐时证明 MoE 循环依然净赚;Truncate or Not?[2] 系统算清了有限算力下前向与反向循环次数的账;Thinking Machines Lab 开源的 Inkling 2 Mini[3] 与 Goodfire 的可解释性追踪[4] 则揭示了双路 Attention Residuals(AttnRes)与内部路由电路。
- 视觉生成侧:在扩散模型(DiT / MMDiT)与 Masked Generative 模型(MaskGIT / MAGVIT)中,ELT[9] 借助前缀自蒸馏让每个采样步支持任意深度的 Any-Time 弹性推理;Looped-DiT[10] 则用深度监督(Deep Supervision)与 Self-Modulating Attention(SMA / XSA)解决了文生图循环中的空间退化难题。
五种 Looped Transformer 架构一览
语言模型三条路线(图 1)均保留非共享首尾层、只循环中间核心块,分别攻克等预算 MoE 缩放、$(T, B)$ 梯度截断与跨循环注意力路由;视觉生成两条路线(见后文图 14 与图 17)则把权重共享循环嵌进每一步采样或去噪内部,既大幅砍掉参数量,又打开了超越增加去噪步数的隐式推理杠杆。
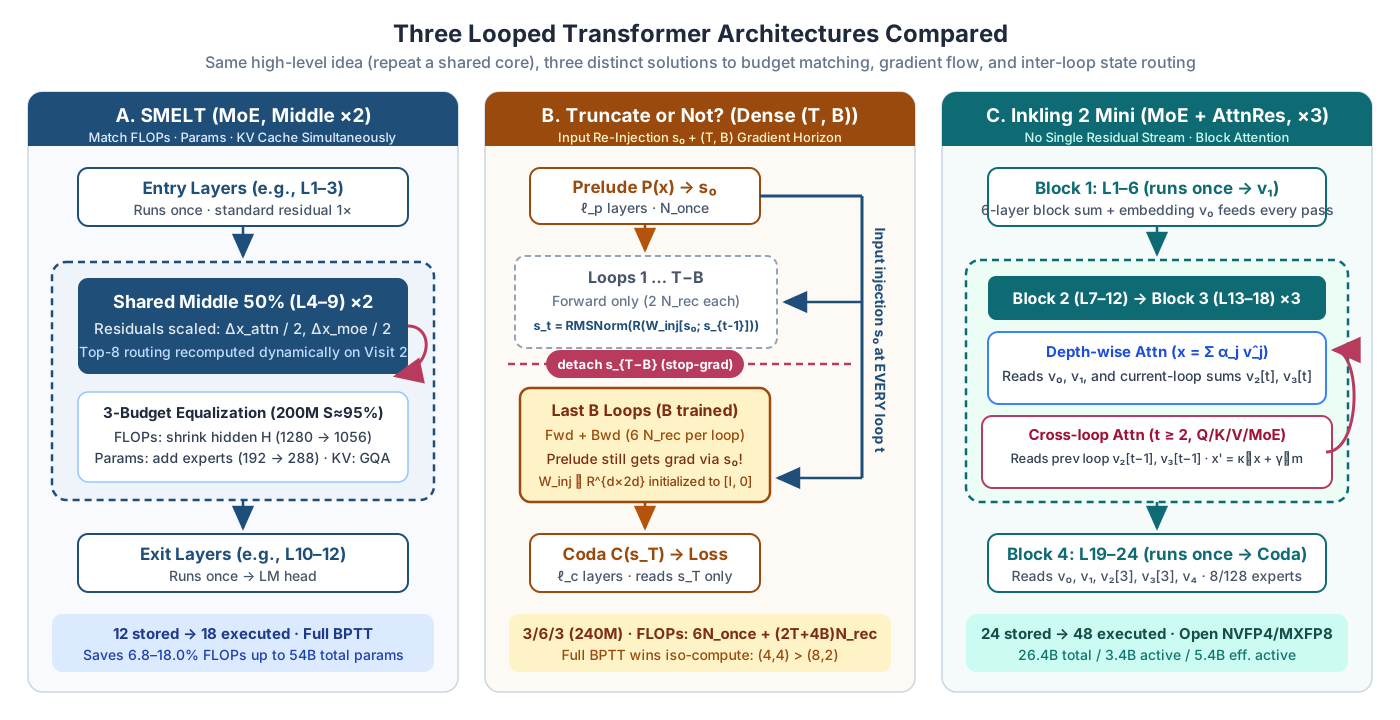
| 架构方案 | 主干与循环跨度 | 状态耦合与监督策略 | 核心结论 |
|---|---|---|---|
| SMELT | 稀疏 MoE (GQA, top-8);中间 50% 层循环 2 遍 | $1/2$ 缩放累加残差;完整 BPTT 训练至 215B tok | 等算力/参数/KV 下前沿省 6.8–18.0% 训练算力 |
| Truncate or Not? | 稠密 Huginn 式(58M–919M);中间层循环 $T\in\{1..16\}$ | 每轮注入 $W_{\text{inj}}[s_0; s_{t-1}]$ + RMSNorm;扫描 $(T,B)$ | 同算力完整反传胜出;$(2,2)$ 少 27% 参数近持平 |
| Inkling 2 Mini | 24 层混合 MoE (8/128);Block 2–3 循环 3 遍(48 层) | 深度 + 跨循环 AttnRes ($\kappa\odot x + \gamma\odot m$);NVFP4/MXFP8 | <100B 开源编码领先(DeepSWE 48.2%);$d_{2027}$ 控跨轮 |
| ELT | MaskGIT / MAGVIT / DiT;单步内 $N$ 层核心块循环 $L$ 遍 | 前缀自蒸馏 ILSD($\lambda: 1\to 0$);Any-Time 弹性截断 | 4× 少参数(FID 2.0 / FVD 72.8);TPU 吞吐 3.5×;DiT 收敛 2× |
| Looped-DiT | 像素空间 MMDiT([6,5,6], 260M);中 5 块循环 $\times 4$(32L) |
深度监督(Final+Mean)+ 无参数 XSA |
均值 71.5 击败 6.5× 大模型;循环优于单纯加去噪步数 |
SMELT:等算力 MoE 循环
三项预算同时对齐的配方
论文 SMELT: Scaling Laws for Compute-Matched MoE Looped Transformers[1] 直面一个核心难题:在常规 12 层模型里把中间 6 层重复跑两遍(实算 18 层),静态参数没变,但单 token FLOPs 和 KV cache 会直接涨一半。此前在稠密模型上做等 FLOPs(Iso-Depth)对比时,为了扣回算力必须砍掉独立参数,导致 $r$ 次循环只相当于 $r^{0.46}$ 份独立层的容量,最终输给不循环基线。SMELT(Sparse MoE Transformer, middle layers Loop Twice)用稀疏 MoE 的参数–算力解耦把三项预算一次对齐:
- 对齐单 token FLOPs(误差 < 4%):主动收窄隐层宽度 $H$(例如 200M、等效稀疏度 $S\approx 95\%$ 档把 $H$ 从 $1280$ 压到 $1056$),抵消多跑一遍中间层增加的计算,单 token 训练算力落在 $1.37\times 10^9$ 对基线 $1.33\times 10^9$($+2.9\%$)。
- 补回非 embedding 总参数量(误差 < 1%):变窄会缩水每个专家的参数,作者保持每层仍只激活 top-8,但把每层专家总数从 $192$ 提到 $288$,总参数精准回到 $3.89\text{B}$ 对 $3.87\text{B}$($+0.4\%$)。
- 对齐 KV cache(误差 < 4%)并做残差缩放:通过减小 attention head 维度并提高 GQA 分组倍率把 KV 显存拉平;循环区域内的 Attention 和 MoE 残差更新均乘以 $1/r$($1/2$),防止共享权重连续写入把残差流放大失稳。
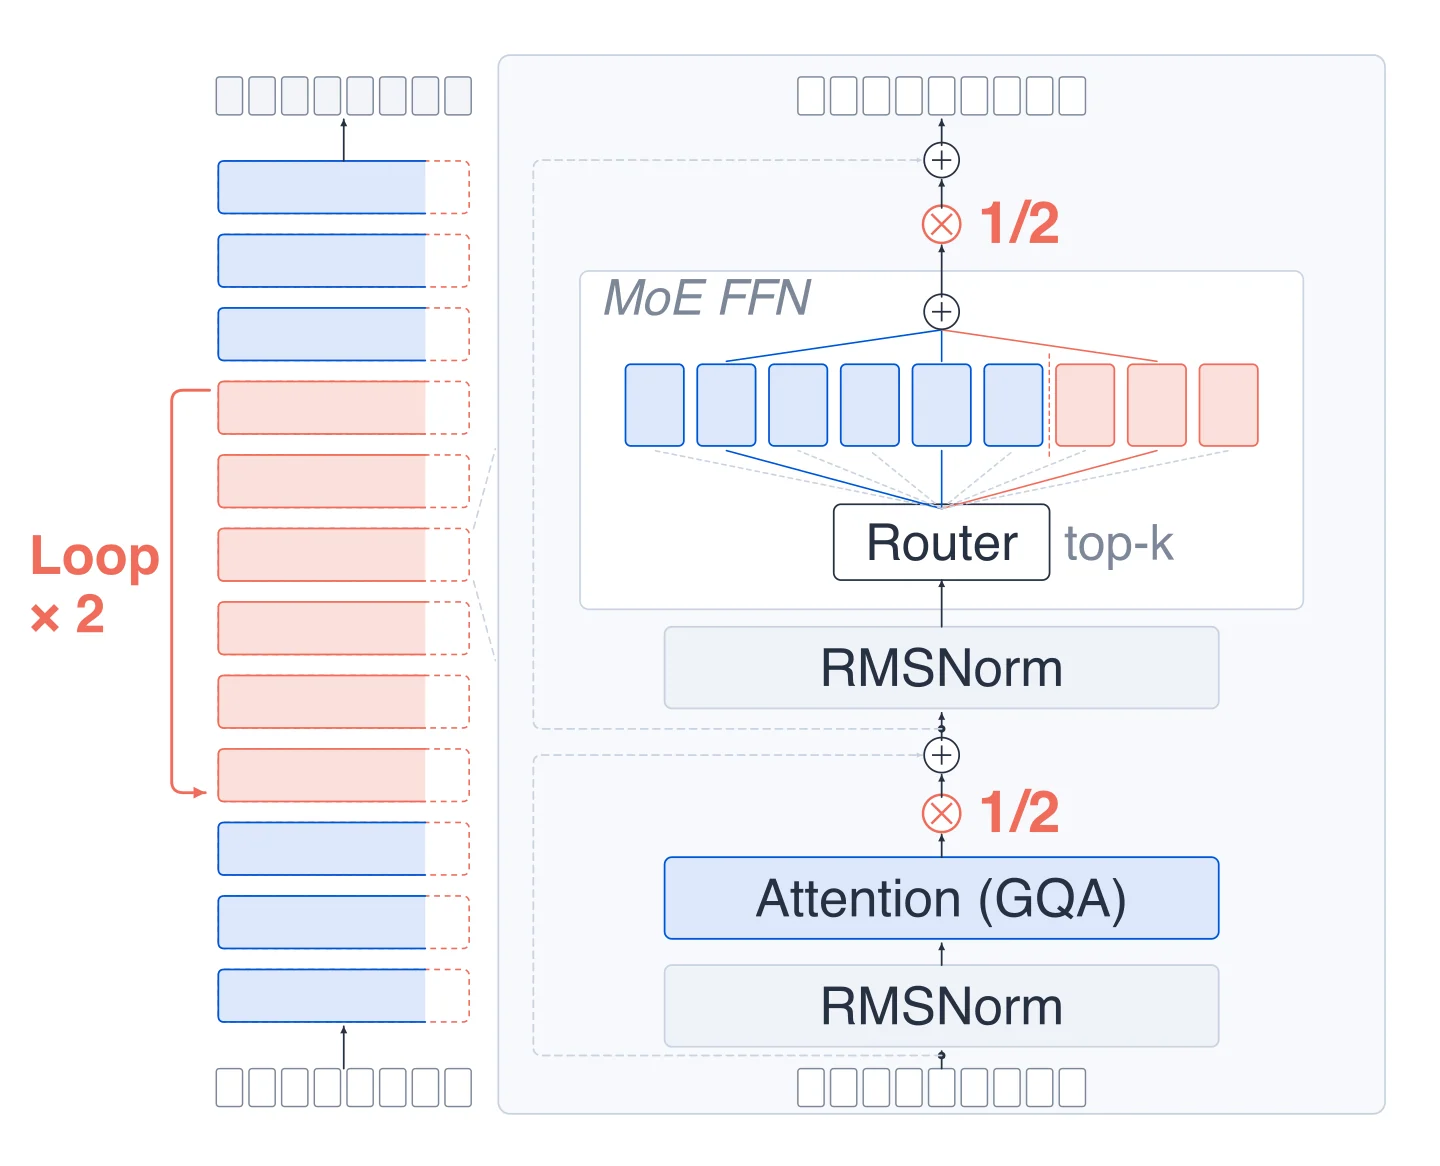
在此对齐协议下,200M 上的三组消融锁死了配方:
- 循环位置:只重复中间 50%(第 4–9 层)在 $S\approx 85\%$($1.9257$ vs. $1.9322$)和 $S\approx 95\%$($1.8517$ vs. $1.8601$)下均优于全栈循环。
- 深宽比:循环模型的最佳有效深宽比大于基线(物理 12 层 / 实算 18 层赢下全部指标),得益于共享块能从多深度反向路径收集梯度。
- 循环次数:算力受限下 $2\times$ 胜过 $3\times$ 和 $4\times$(验证 loss $1.9257$ vs. $1.9385 / 1.9360$),因为再增加遍数会把隐层宽度压得太细。
Scaling Law 与超越 Loss 的下游收益
作者将该配方扩展到 $4 \times 4$ 实验网格(100M / 200M / 600M / 1.6B 四个激活规模,配 $S=0\%$ 稠密参照及 $S\approx 85\%, 95\%, 97\%$ 三档稀疏度,非 embedding 总参数量最高 53.9B,WSD 稳定–退火到 215B tokens),SMELT 在全部 16 个网格点上均低于基线。由 FLOPs 比值定义等效计算稀疏度 $N_{\text{act}}^{\text{eq}} = (F/F_0)N_0$、$S = 1 - N_{\text{act}}^{\text{eq}}/N$,分别拟合 Chinchilla 风格 MoE Scaling Law:
$$\begin{aligned} \mathcal{L}(F, S, D) &= E + \frac{A\,(1 - S)^b}{F^a} + \frac{K}{D^c}, \\ \mathcal{L}^*(C, S) &= E + f(A,K,a,b,c,S)\,C^{-\gamma}, \qquad \gamma = \frac{ac}{a+c}. \end{aligned}$$在稀疏主战场($S \approx 85\text{–}97\%$),SMELT 的容量指数($a = 0.3892$ vs. $0.3703$)与数据指数($c = 0.7011$ vs. $0.6594$)同步提高,前沿斜率 $\gamma$ 提升 $+5.5\%$($0.250$ vs. $0.237$)。按同验证 loss 反查算力,SMELT 在 $10^{20}$ FLOPs 节省 6.8–10.0% 训练算力,到 $10^{21}$ FLOPs 扩大到 14.7–18.0%(外推 $10^{22}$ 约 $19.6\text{–}23.5\%$),且最优单参数 token 配比(~56–91 TPP)几乎不用改动。
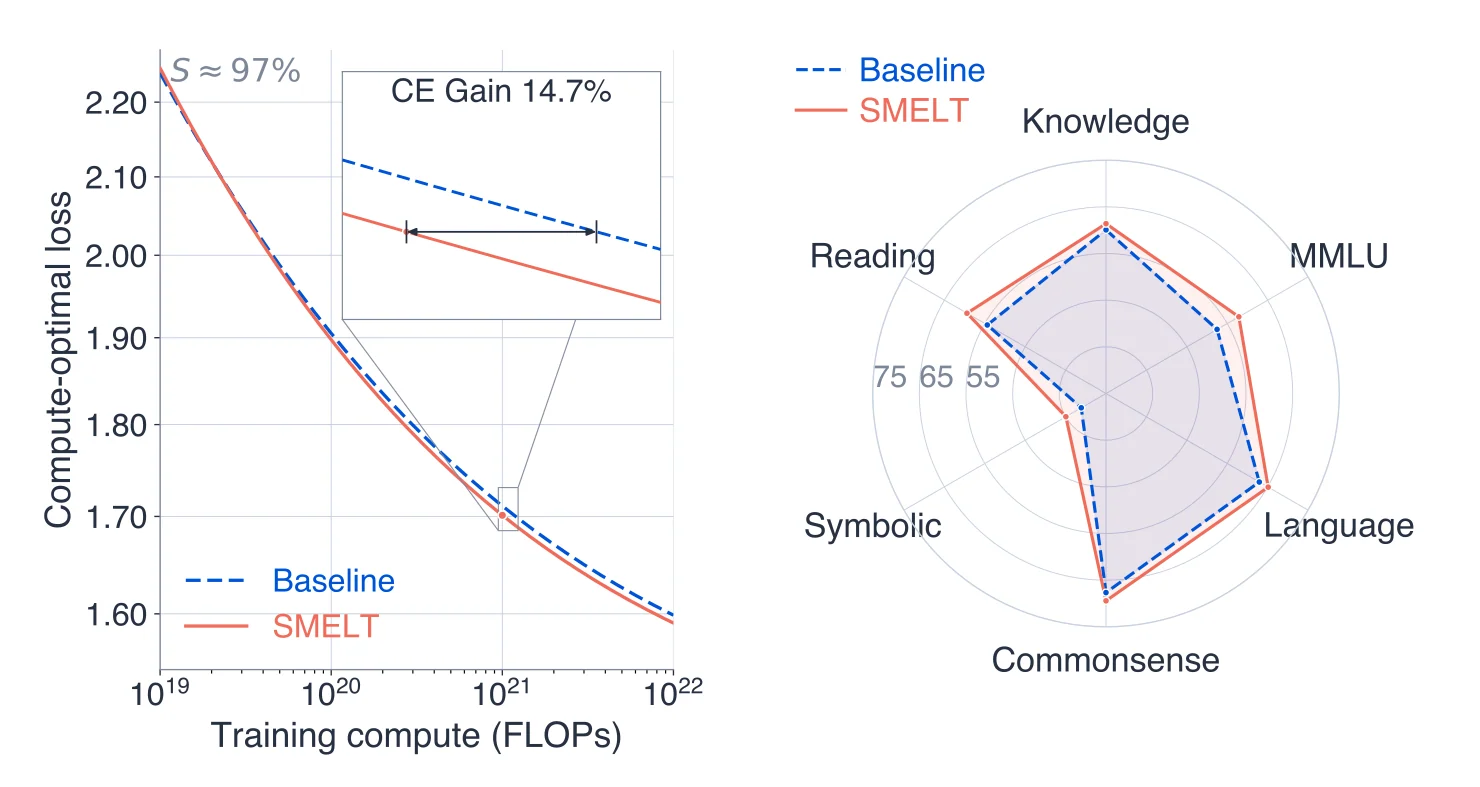
更有意思的是,下游指标涨幅比验证 loss 预测的还高:
- 配对胜率与 Sigmoid 正残差:96 对配对评估中,SMELT 在 DCLM Completion 赢 96/96、DCLM Core 赢 83/96、高于随机基线的 MMLU 赢 29/30;用基线数据拟合「loss → 得分」Sigmoid 曲线后,SMELT 的正残差随规模单调放大(1.6B 时 Completion 多降 $12.3\text{ millinats}$、Core 高 $+1.2\text{ pp}$,其中符号推理以 $+1.9\text{ pp}$ 反超阅读理解)。
- 结构化领域收益最突出:按验证域拆分算力节省,结构化最强的 Code 高达 20.4%(其次 Finance $16.8\%$、Math/STEM $16.6\%$,Web 为 $14.8\%$)。
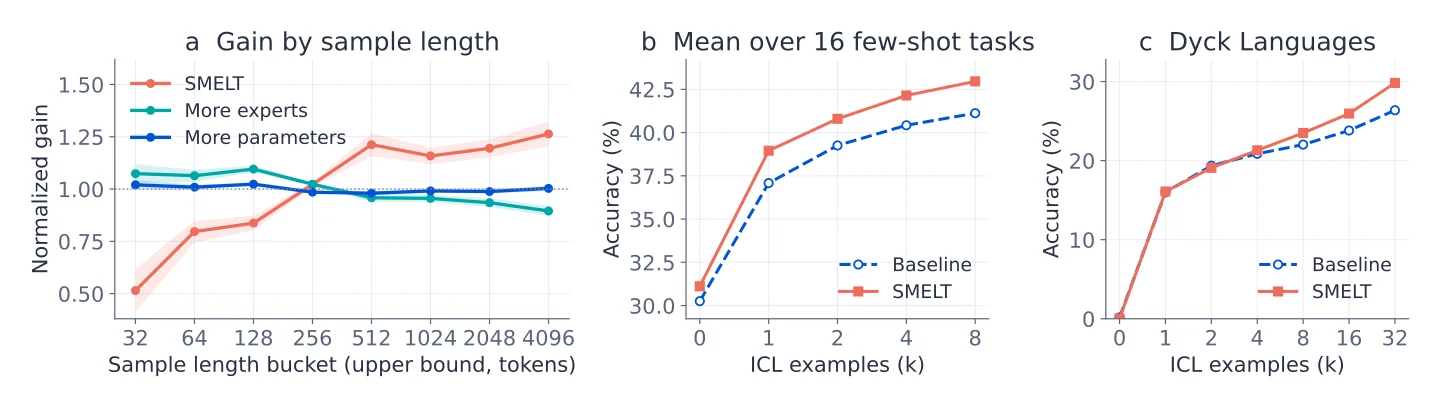
- 长文本放大效应:对长样本($512\text{–}4096$ vs. $32\text{–}256$ tokens)增益放大至 $1.52\times$,而单纯加参数或加专家的对照组几乎走平($0.98\times$ 和 $0.88\times$)。
- 少样本 ICL 与 Dyck 匹配:上下文学习示例一出现($k\ge 1$),优势就从 $0.9\text{ pp}$ 拉大到 $1.9\text{ pp}$,32-shot Dyck 括号匹配达到 $29.8\%$ vs. $26.4\%$。
第二遍循环到底在算什么
在 1M 验证集上探测共享中间层两次经过时的内部变化,可以确认第二遍并非机械复读,而是沿着第一遍铺好的索引轨迹做深度加工与信息提纯:
- §6.1 专家路由“部分复用 + 部分换将”:高稀疏度 $S\approx 97\%$ 下,同一 token 两遍经过同一层 Router 时仍稳稳复用 2–3 个核心专家(远高于均匀随机 $8^2/504\approx 0.13$),同时把其余 5–6 个槽位路由给不同专家,在共享权重上走出差异化计算路径。
- §6.2 残差更新更强且方向一致:全部 16 个网格里,第二遍的 Attention 与 MoE 写入范数均放大至 1.2–3.5×(由于方向变化触发 RMSNorm 逐维缩放,送入子层的归一化输入本身已放大);且同物理层跨两遍更新方向的余弦相似度达 $0.42\text{–}0.65$(均值 $0.56$,错层仅 $0.16$),说明是在强化细化而非推翻覆盖。
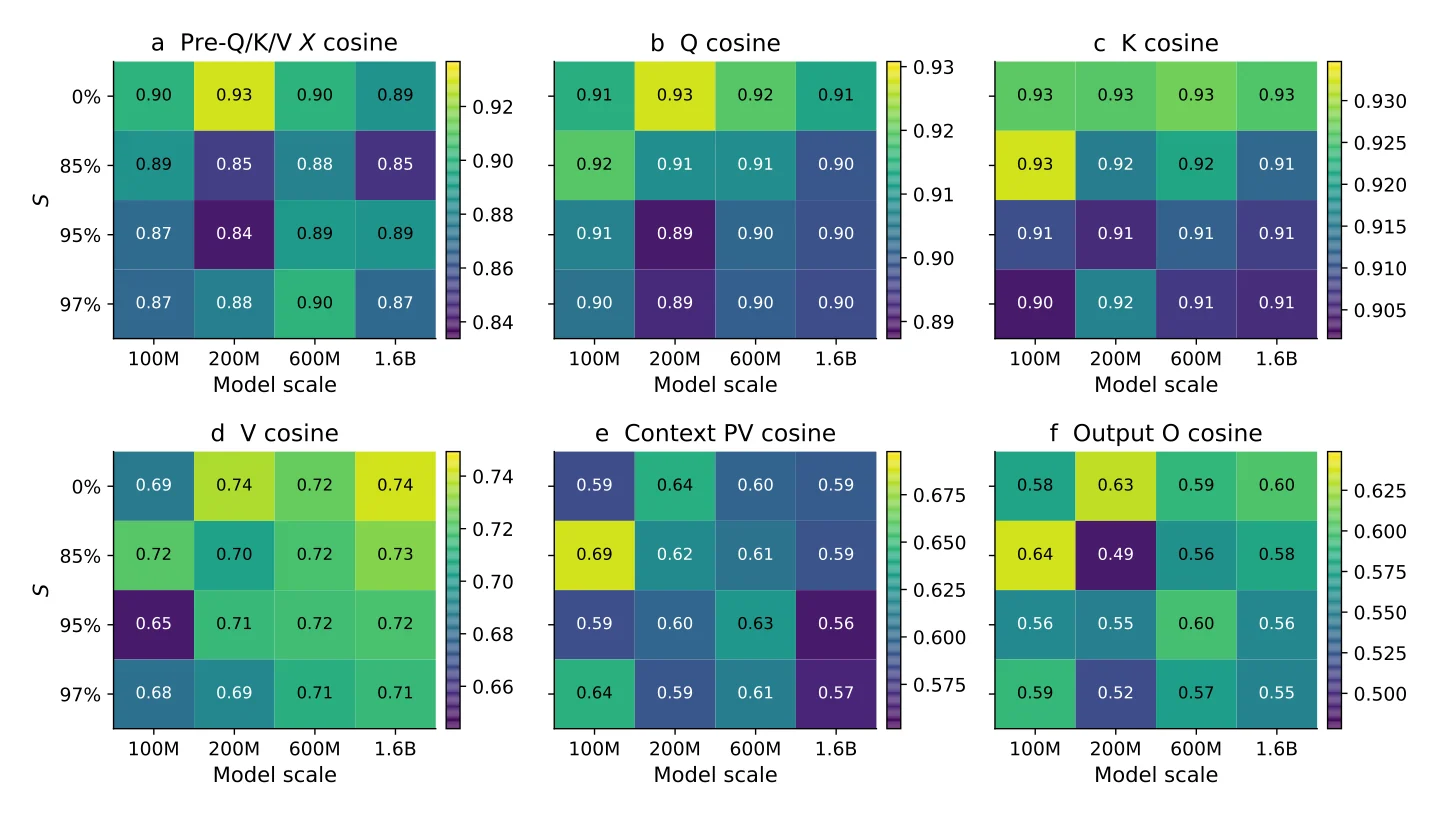
- §6.3 Q/K 稳定锁定坐标,V 重写读取内容:第二遍重算后,$Q, K$ 跨遍余弦仍达 $0.89\text{–}0.93$(甚至不低于输入 $X$ 的 $0.84\text{–}0.93$),离散 top-8 关注 token 重合度达 56–66%(同层异头对照仅 $28\text{–}34\%$);而 $V$ 相似度跌到 $0.65\text{–}0.74$、输出 $O$ 进一步分化($0.49\text{–}0.64$)——“看向哪里”基本保留,“从那里读什么”发生了实质更新。
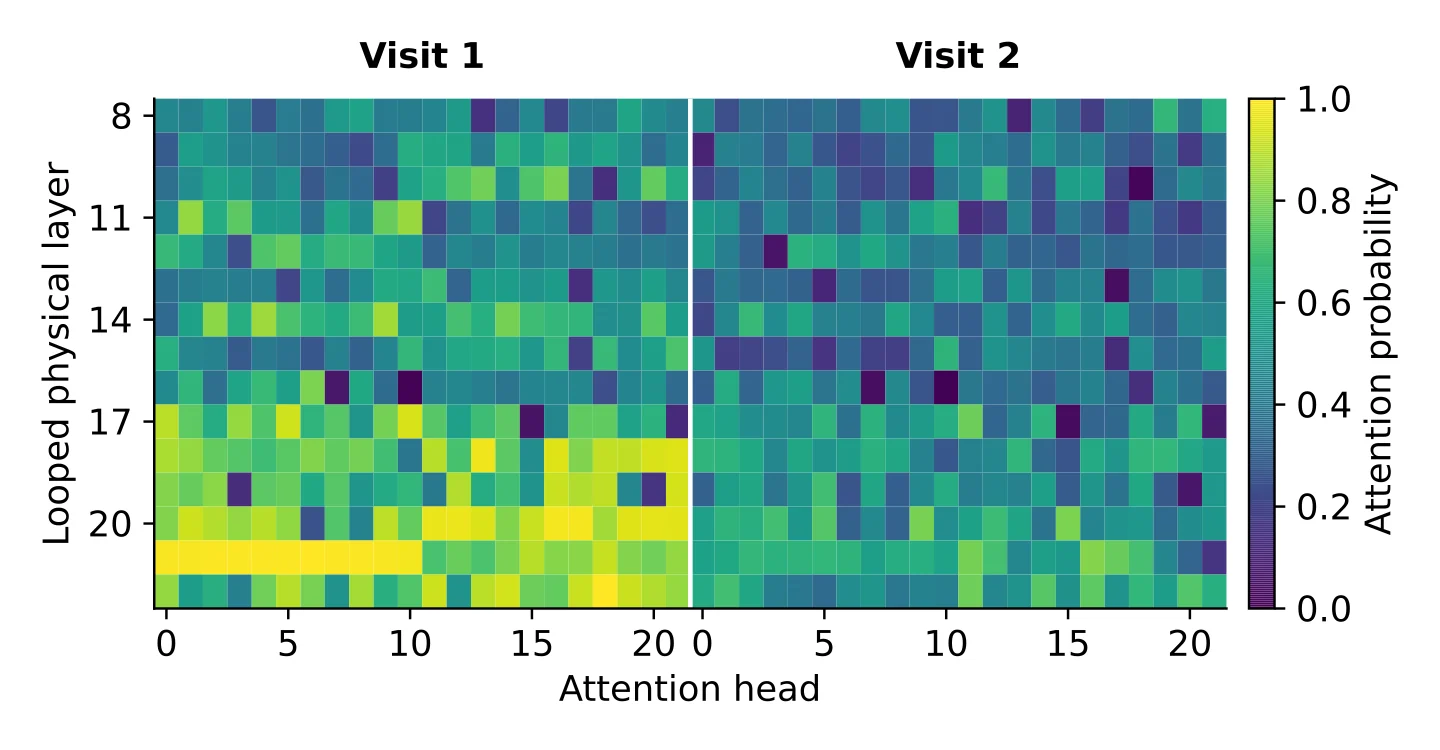
- §6.4 压低 Attention Sink、转向示例答案:1.6B Dyck 任务中,关键 head 在 BOS 的 sink 权重从 60% 骤降到 2%,示例答案上的权重从 24% 飙升到 85%;在 1M 通用验证语料上,第二遍同样普遍削弱了各 head 的初始 token 聚集,甚至逆转了常规架构越往深层 sink 越重的趋势。
Truncate or Not?:梯度截断与训练算力账
Input Injection 与 (T, B) 算力核算
论文 Truncate or Not? A Scaling Study of Looped Transformers with Truncated Backpropagation[2](港大 MMLab 与耶鲁)在 FineWeb-Edu 上一口气跑了 592 次训练($58\text{M}\text{–}919\text{M}$ 非 embedding 参数),专门回答训练循环模块时「该截断反传还是完整反传」。模型沿用 Huginn[7] 风格的 Prelude–Recurrent–Coda 三段式结构(如 240M 为 $3/6/3$ 层,循环 4 遍共执行 $3+4\times 6+3=30$ 层):
$$s_0 = \mathcal{P}(x),\qquad s_t = \Phi_\theta(s_{t-1}; s_0) = \operatorname{RMSNorm}\!\Big(\mathcal{R}\!\big(W_{\text{inj}}[s_0;\,s_{t-1}]\big)\Big),\qquad p = \mathcal{C}(s_T).$$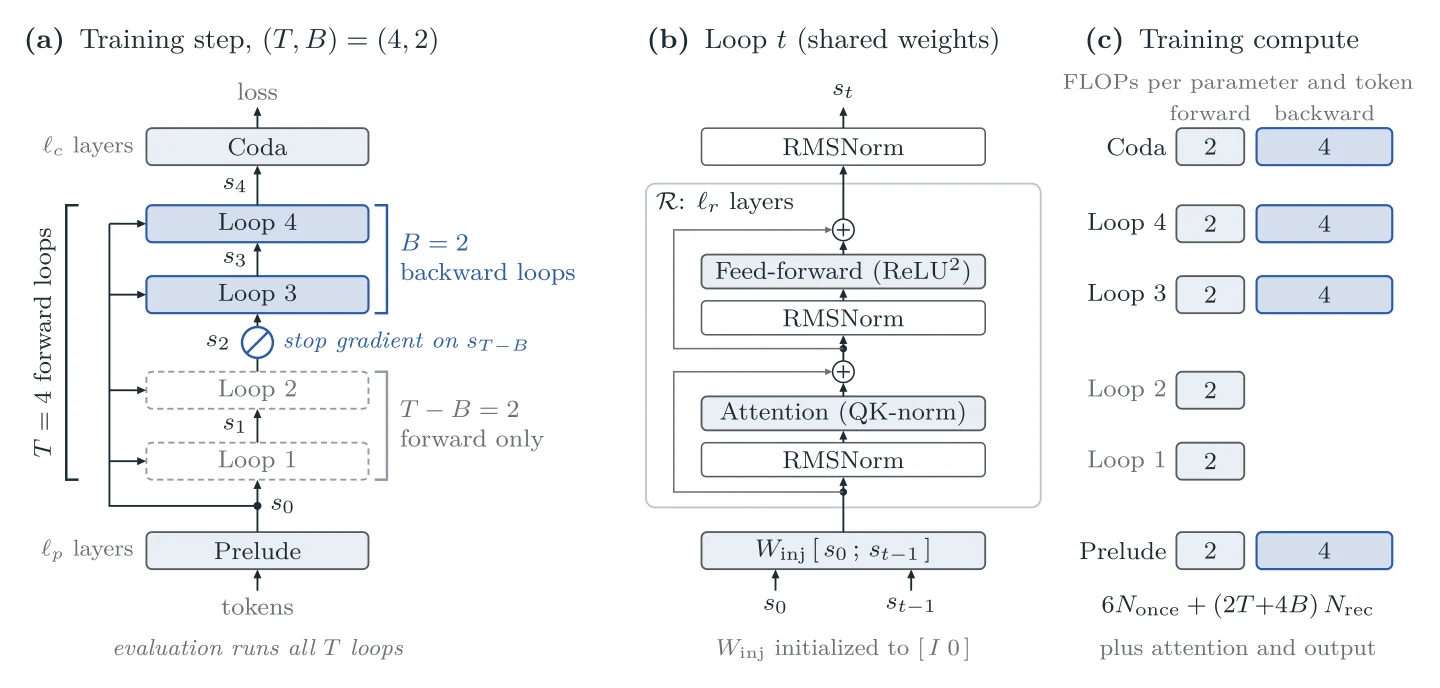
这一循环结构有三个关键机制:
- 每轮 Input Injection(重新注入 $s_0$):拼接 $[s_0; s_{t-1}]$ 后用 $W_{\text{inj}}\in\mathbb{R}^{d\times 2d}$ 投回 $d$ 维(初始化为 $[I, 0]$,先吃初始输入再逐步学会融合上一轮状态),末尾 RMSNorm 稳住隐状态尺度。
- 梯度截断 $(T, B)$:前向完整跑完 $T$ 轮,仅在第 $T-B$ 轮输出 $s_{T-B}$ 上做
detach,只有最后 $B$ 轮和 Coda 进计算图——但别漏掉旁路,Prelude 依然会通过最后 $B$ 轮对 $s_0$ 的注入收到梯度。 - 前反向算力对称性:按单轮前向约 $2N_{\text{rec}}$、反向约 $4N_{\text{rec}}$ FLOPs 估算,等效计算参数量 $N_{\text{comp}}$ 满足:
省 2 轮反向省出的 $8 N_{\text{rec}}$ 恰好够多跑 4 轮前向,因此 $(8, 2)$ 和 $(4, 4)$ 循环成本完全相等(同为 $24 N_{\text{rec}}$,$T+2B=12$),$(4, 1)$ 与 $(2, 2)$ 也完全相等。从不动点理论看,截断 $B$ 步相当于只保留 Neumann 级数 $\sum_{k=0}^{B-1}(\mathcal{J}^\star)^k \partial_\theta\Phi^\star$ 的前 $B$ 项;当总轮数只有 $T=2\text{–}8$、隐状态离收敛不动点尚远时,丢掉前段梯度会在每一步积累偏差。
有效参数 Scaling Law 与三类决策场景
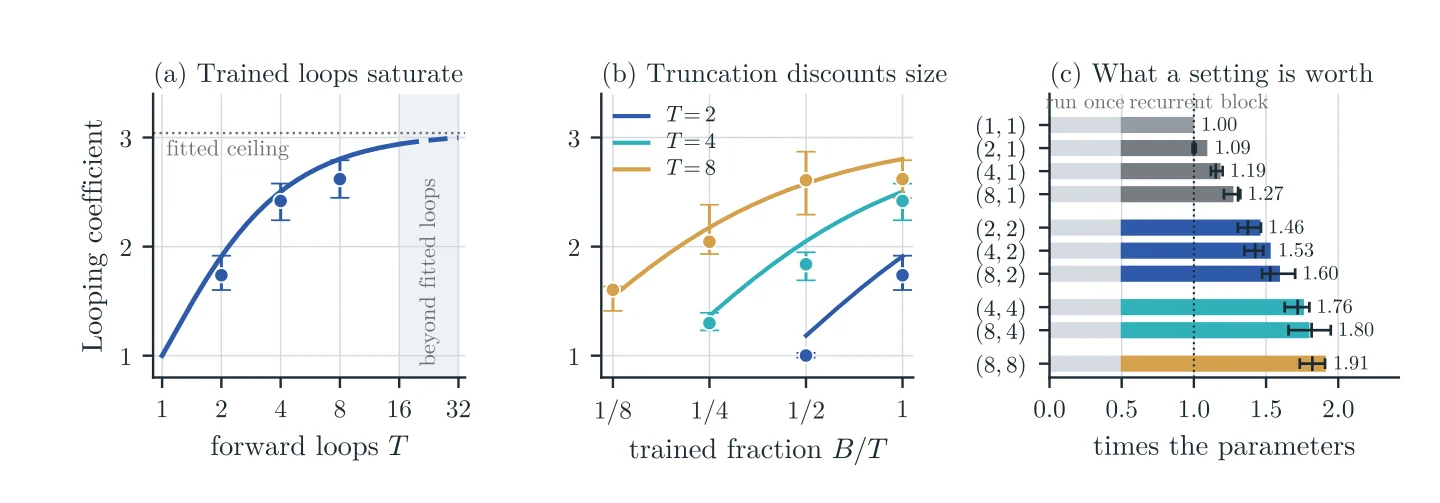
用饱和型循环系数 $g(T, B)$ 放缩循环块的有效参数量(拟合 230 组配置 $R^2=0.9992$,样本内 RMSE $6.14\times 10^{-3}$ nats,留出(held-out)$(T, B)$ 配置的外推误差 $8.67\times 10^{-3}$,比无上限的幂律拟合少近一半误差):
$$\begin{aligned} L &= E + \left[A\left(\frac{N_{\text{eff}}}{N_0}\right)^{-\alpha} + H\left(\frac{D}{D_0}\right)^{-\beta}\right]^{\kappa}, \\ N_{\text{eff}} &= N_{\text{once}} + g(T,B) N_{\text{rec}}, \qquad g(T, B) = \exp\!\Big[c\,(1 - T^{-p}B^{-q})\Big]. \end{aligned}$$全数据集拟合得到 $c \approx 1.112$、$p \approx 0.237$、$q \approx 1.022$(饱和上限 $e^c \approx 3.04$),关键在于 $q \gt 2p$ 且差距超过两倍。在等算力约束 $T+2B=S$ 下极小化 $T^{-p}B^{-q}$(引理 D.2)可以严格证明:只要 $q \ge 2p$,最优解永远压在边界 $T^* = B^* = S/3$——也就是说,用多余前向轮数换取完整反传的「反向每一轮」,比保留一堆无梯度前向更划算。
| 决策约束 | 最优策略 | 关键实验与拟合数据 |
|---|---|---|
| 前向轮数固定 ($T=8$) | 截断至 $B^* = 2$ | 极小化单位算力效率 $\chi = N_{\text{comp}}/N_{\text{eff}}$,把省下算力分给 $1.51\times N,\,1.20\times D$,同 loss 省 33–35% FLOPs |
| 前向轮数可调(同 $N, D$) | 完整 BPTT ($B=T$) | 5 个规模下 $(4,4)$ 全胜 $(8,2)$(240M: $2.2642$ vs. $2.2778$ nats),前沿同 loss 省 8–14% 算力 |
| 参数量 $N$ 固定(显存受限) | 慢扩循环、快扩数据 | 完整反传渐近率 $T^* \propto C^{0.24}$、$D^* \propto C^{0.76}$;$(1,1)\to(2,2)$ 约 14–17 TPP 切换,$(2,2)\to(4,4)$ 实测约 200 TPP 切换 |
| 参数与数据全自由(稠密) | $(1,1)$ 省算力 / $(2,2)$ 最佳循环 | 近等算力下 $(2,2)$ 344M 与 $(1,1)$ 471M 几乎打平($2.3677$ vs. $2.3663$),非 embedding 参数少 27%;$+8\%$ 算力即以 $2.3590$ 反超 |
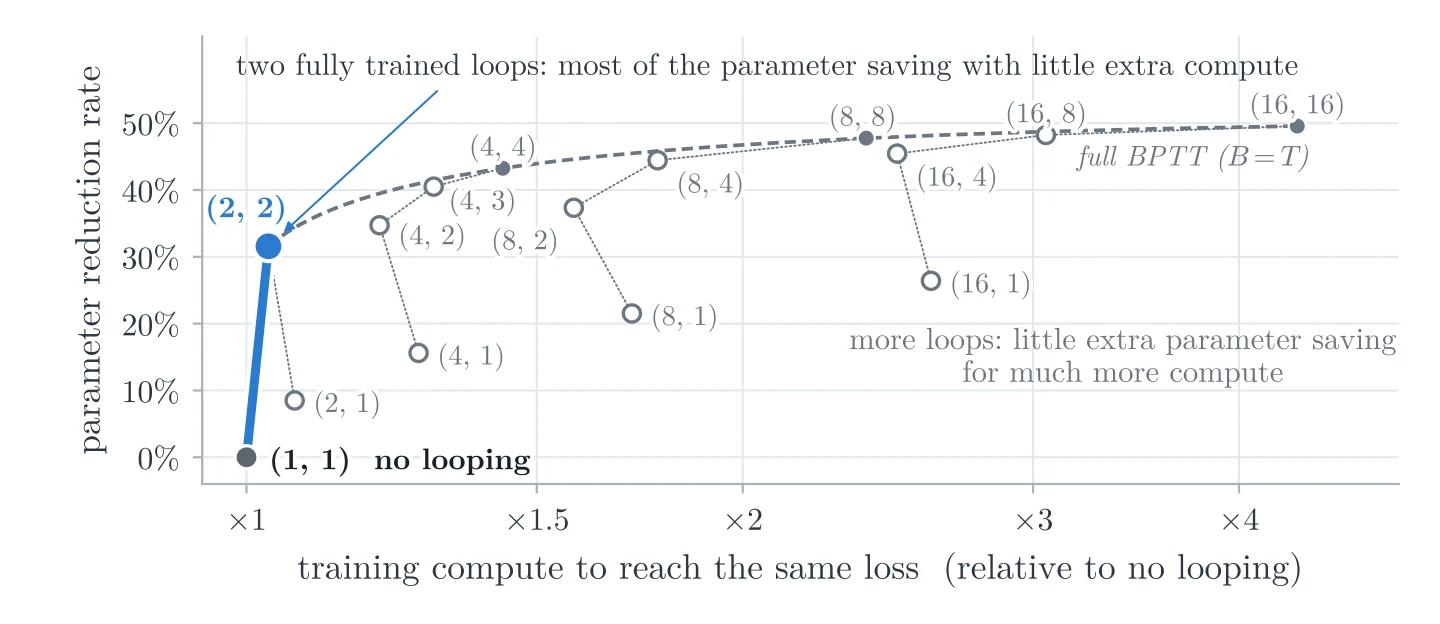
把稠密(Truncate or Not?)和稀疏(SMELT)串起来看:表面上一个说「自由参数时别循环最好」,另一个说「MoE 循环能省 6.8–18.0% 算力」,其实两者根本不矛盾,甚至在核心结论上高度合拍——两项研究各自独立发现 「完整反传 + 循环 2 遍」是最优甜点。差别在于稠密模型绑定参数后,$g(2,2)\approx 1.910 \lt 2$ 无法释放多余算力去补参数;而 SMELT 靠稀疏 MoE 把变窄省出的权重空间变成更多专家,加上二次访问天然触发专家重路由,最终打破了稠密模型的收益上限。
Inkling 2 Mini:生产级 Looped MoE 与内部电路
Attention Residuals 与跨循环数据流
由 Thinking Machines Lab 发布(Introducing Inkling 2 Mini[3][5])并由 Goodfire 进行可解释性剖析(Interpreting Inkling 2 Mini[4])的 Inkling 2 Mini(Apache 2.0),把 Looped MoE 做成了本地笔记本(~20GB 原生 NVFP4/MXFP8 权重、1M 上下文)可跑的多模态推理模型:26.4B 总参数、3.4B 静态激活、跨 3 轮等效 5.4B 激活;24 个物理层($d=2304$,训练中从 384 专家剪枝至 top-8 of 128 并经 1T token 蒸馏修复与 2.2T token RL)按每 6 层切分为 4 个 Block——Block 1($1\text{–}6$ 层)和 Block 4($19\text{–}24$ 层)各跑一遍,中间 Block 2、3($7\text{–}18$ 层)循环 3 遍共执行 48 层。
- 循环位置消融:中间 12 层循环在 28 项评测中以 27/28 胜过尾部 12 层循环(等效算力增益 $1.51\text{–}1.91\times$ vs. $1.24\text{–}1.36\times$)。
- 长程推理对照:512k 长轨迹测试里,不循环对照版需要多花 $140\%$ 推理算力才能追平同等的验证 loss(训练算力仅省 $7.5\%$)。
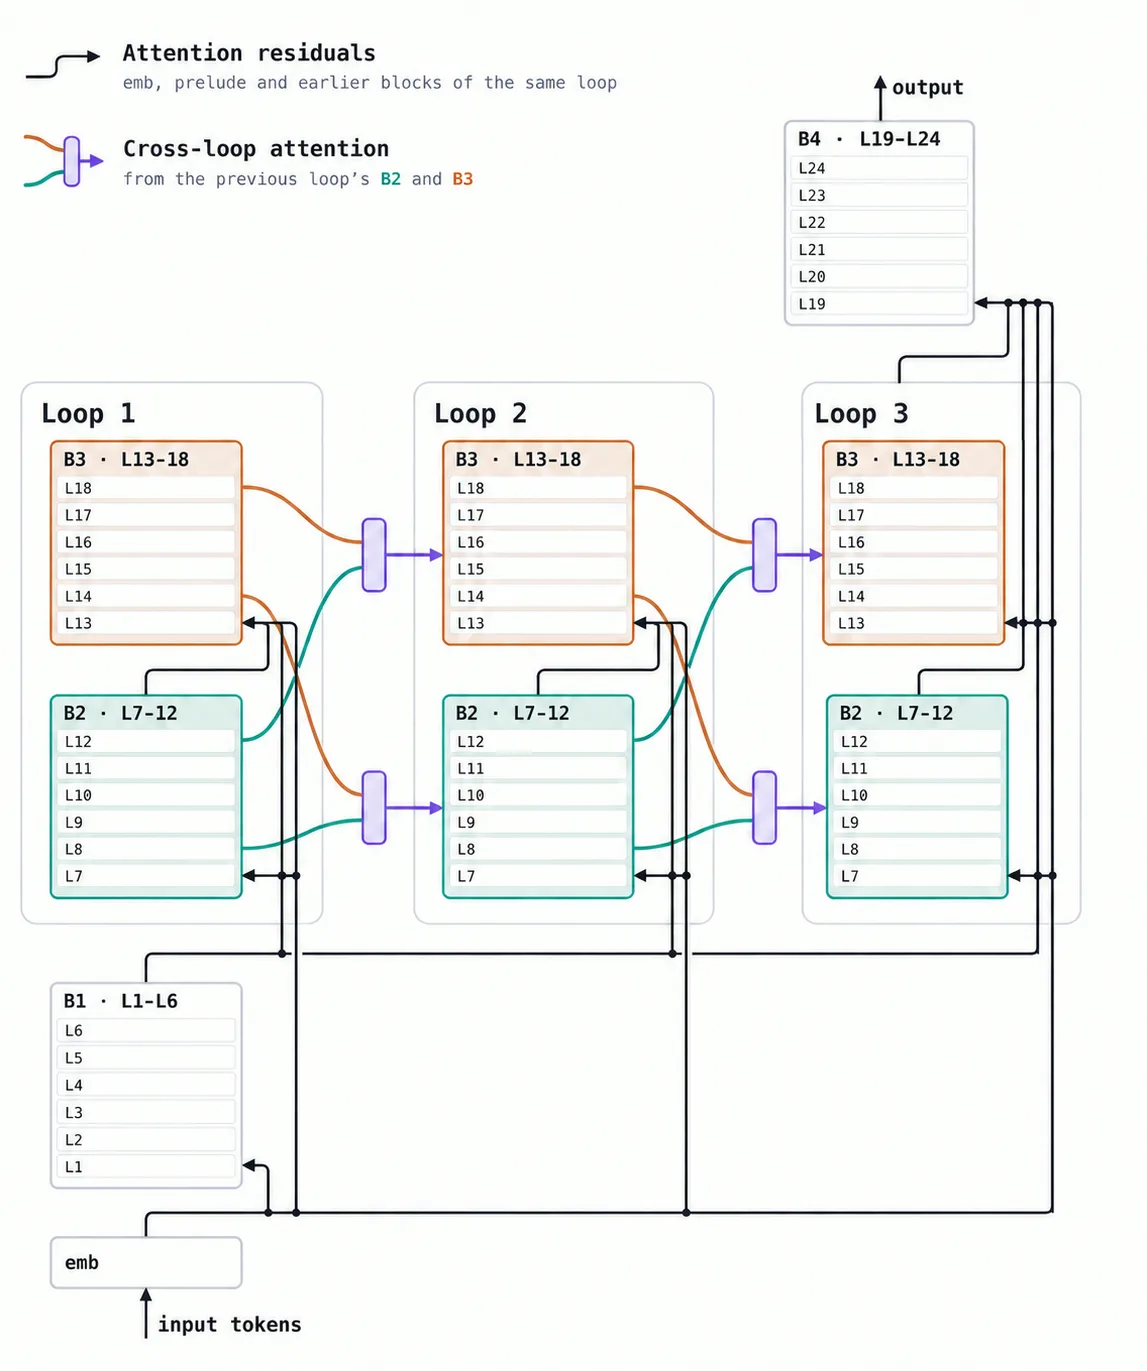
架构上最核心的创新,是用块级 Attention Residuals(AttnRes)[8] 加 Cross-Loop Attention(跨循环注意力)取代了单条累加残差流:每个 Block 从零累加各自 6 层 Attention + MoE 的输出得到 $\mathbf{v}_i$(嵌入层记为 $\mathbf{v}_0$),每个子层输入则经两条路径融合而成:
- Depth-wise Attention(沿深度维度的注意力):单 token 进子层前,先对当前循环前面各个块的输出做归一化加权,读取 $\mathbf{x}=\sum_j\alpha_j\hat{\mathbf{v}}_j$。
- Cross-Loop Attention(跨循环注意力):从第 2 轮起,每层用 4 组独立查询向量 $\mathbf{u}_{Q,K,V,\text{MoE}}$ 读取上一轮的 Block 2 和 Block 3 输出,再经 64 维瓶颈门控混合:
其中增益 $\boldsymbol{\gamma}$ 初始化为 0,保证训练初期与普通不循环模型完全一致,再平滑打开跨轮通道。
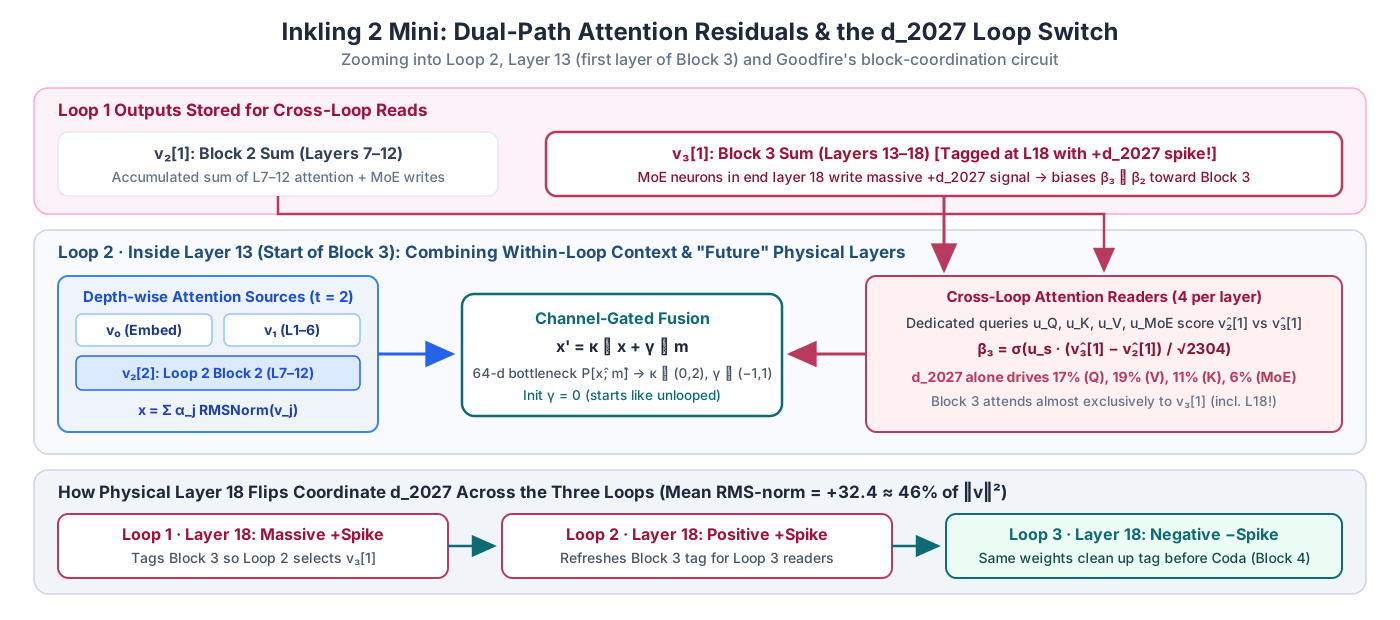
由于整条路径可以精确拆成之前所有层输出 $\mathbf{o}_w$ 的线性加权和 $\mathbf{x}'=\sum_w \mathbf{c}_w$(投影份额 $s_w = (\mathbf{c}_w \cdot \mathbf{x}')/\|\mathbf{x}'\|^2$ 之和恒为 1),Goodfire 的信息流分解捕捉到一个反直觉现象:第 2 轮第 13 层(Block 3 首层)本轮已通过 Depth-wise Attention 拿到 Block 2($\mathbf{v}_2^{[2]}$),于是 Cross-Loop Attention 几乎全部转去读上一轮的 Block 3($\mathbf{v}_3^{[1]}$)——其中包含第 18 层的输出,等于在跨轮通道里直接读取了「物理层号在自己之后」的结果。
权重打标与异常维度 d2027 开关
没有人为规定路由规则,模型怎么学会每一轮该去读哪一块?Goodfire 在 13,233 个 FineWeb token 上从权重和激活两头挖出了具体回路:
- 块末层的权重“打标(Tagging)”:扫描全部 24 层 $3{,}538{,}944$ 条 MoE down-projection 写入向量与 $104$ 个 Block Reader 查询向量,在绝对余弦最高的 3,490 对($|\cos| \ge 0.30$,前 $0.001\%$)里,几乎全挤在每块最后一层——层 6/12/18 集中写给 Block 4 的 Depth-wise Reader,而跨循环写入高度集中在 Block 3 末层(层 18)并精准对准下一轮 Block 3 首层(层 13)。
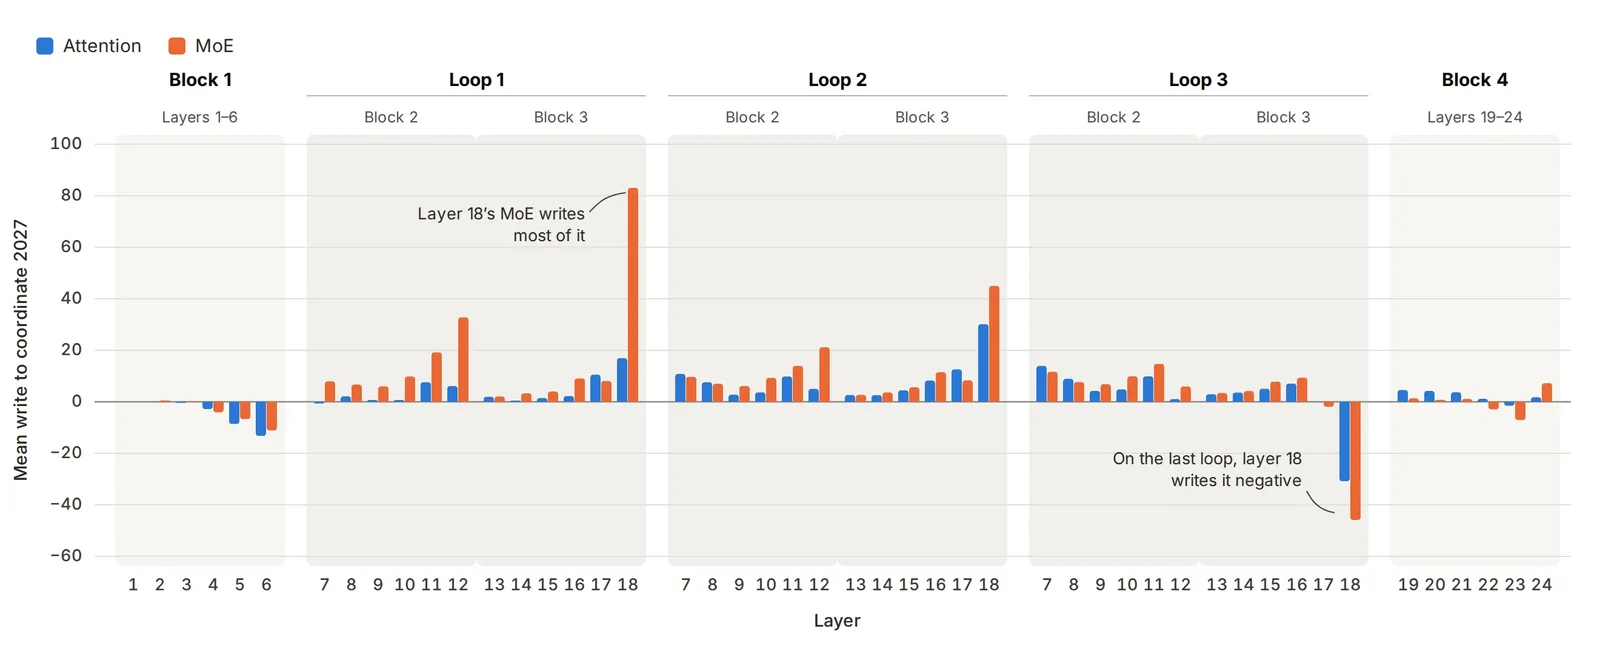
- 超级异常维度 $d_{2027}$ 独扛半壁江山:RMS 归一化后向量平方范数恒为 $d=2304$(均摊每维贡献 $0.043\%$),但单单第 2027 维均值就飙到 $+32.4$,一维独占 46% 的总平方范数。由于 $\beta_3 = \sigma(s_3 - s_2) = \sigma\!\big(\frac{1}{\sqrt{2304}}\sum_i u_i(\hat{v}_{3,i}-\hat{v}_{2,i})\big)$,在 Loop 2 第 13 层仅凭 $d_{2027}$ 一维就分别解释了 Block 3 相对 Block 2 logit 差值的 17% ($Q$)、19% ($V$)、11% ($K$) 和 6% (MoE)(前 5 异常维合计占 60%/62%/32%/30%)。
- 同一层权重的三轮“过河拆桥”开关:最震撼的是,同样一套层 18 权重,在 Loop 1 和 Loop 2 结尾往 $d_{2027}$ 狠狠写入大正值(给下一轮发信号读取 Block 3),到了最后一遍 Loop 3 结尾,因为后面没有循环了、马上进 Block 4 解码,层 18 竟在同一维度上写出大幅负尖峰主动清零标志位!
中间层解码、推理边界与可监控性
Goodfire 在 1,250 篇 FineWeb 文档上对比了几种中间表征解码方法:直接套最终 unembedding 的 Logit-lens 只有在每轮接近第 18 层结尾时才像点样;而用仿射对齐的 Tuned-lens 或直接拿原模型 Block 4(Coda)跨序列推理中间隐状态的 Coda-lens,哪怕在很早的循环轮次就能以高 top-50 命中率和概率质量还原最终答案。说明模型即便把大量推理折进了循环隐空间,中间计算依然保持可解码结构。
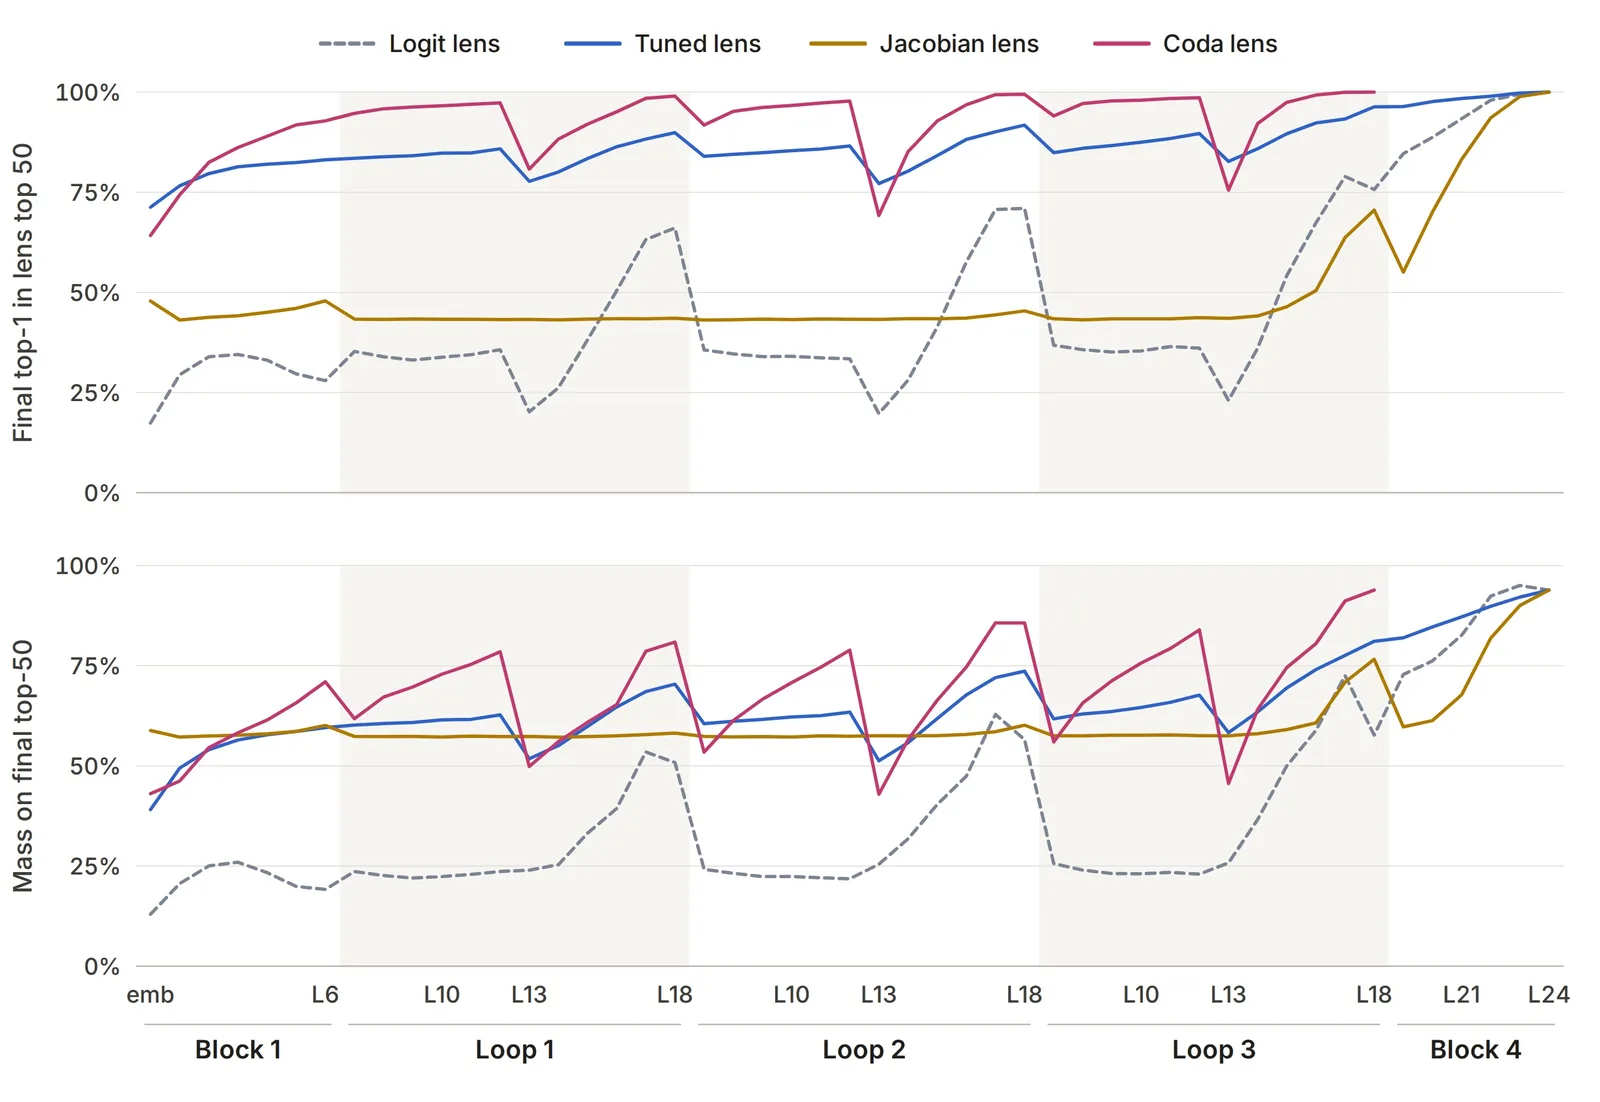
结合 Inkling 2 Mini(DeepSWE v1.1 达 $48.2\%$、Vals Index v2.2 达 $46.5\%$、DGX Spark 上每瓦智能得分(intelligence/watt)$0.703$ 显著领先 Qwen3.6-35B-A3B 的 $0.430$)和可调循环研究版 TML-d24-varloop-research,Thinking Machines 还把循环的推理收益与 CoT 安全监控边界拆得很清楚:
- 循环加推理不加死记知识:在不写 CoT 的 Think Fast 评测中,随循环从 1 次增至 3 次,50% 可靠率对应的时间跨度(50%-reliability horizon)从 $16\text{ s}$ 提到 $37\text{ s}$,并在训练未见过的 10 次循环上稳定维持($40\text{ s}$);纯多跳串行任务 N-Hop Lookup 直到 10 次循环仍在提分。但闭卷事实问答(closed-book QA,如 SimpleQA Verified、AA-Omniscience)几乎不随循环增长——知识存储上限依然卡在 $26.4\text{B}$ 权重容量,靠高频工具与搜索能力(BrowseComp $79.0\%$、DeepSearchQA $85.3\%$)补足。
- 思考链变短了,却没有“隐身”:在各循环遍数都答对的 GPQA Diamond 题目上,循环增加让思考 token 砍掉一半多,省下的主要是「wait / actually / hmm」式自我回溯与反复试错,平均句长与英文词典可读率几乎不变;模型操控 CoT 规避检查的能力也极低($\le 0.1\%$),在完整监督下的 LinuxArena 恶意隐藏率保持 $0.3\text{–}1.3\%$(官方同时提示,针对更多循环遍数专项 RL 的大模型仍需持续监控)。
| GPQA Diamond 已解题思维链指标 | 1 Pass | 3 Passes | 5 Passes |
|---|---|---|---|
| 平均思考 token 数 | 3,703 | 1,731 | 1,661 |
| 平均每句词数 | 8.9 | 8.7 | 8.7 |
| 英文词典词汇占比 | 94.6% | 94.5% | 94.4% |
| 回溯/犹豫词("wait", "hmm" 等)出现次数 | 9.7 | 3.9 | 3.6 |
ELT:视觉生成的弹性循环与自蒸馏
ILSD 循环内自蒸馏与 Any-Time 弹性推理
不同于自回归语言模型每步只生成一个 token,扩散模型(DiT[9])与 Masked Generative 模型(MaskGIT/MAGVIT)本身就有外层的 $K$ 步采样/去噪循环。ECCV 2026 论文 ELT: Elastic Looped Transformers for Visual Generation 在每一步采样内部又嵌套了一条正交的权重共享循环:把由 $N$ 个独立层构成的复合块 $g_\Theta(\mathbf{x}) = f_{\theta_N}(\cdots f_{\theta_1}(\mathbf{x}))$ 连续重用 $L$ 遍,即 $F_{(N,L)}(\mathbf{x}) = g_\Theta^L(\mathbf{x})$,仅存 $N$ 套权重即可跑出 $\mathcal{D} = N\times L$ 的执行深度。紧致参数 $\Theta$ 让计算密度(Arithmetic Intensity,FLOPs/Byte)提高最高 $L$ 倍,在硬件侧直接缓解 HBM 带宽墙。
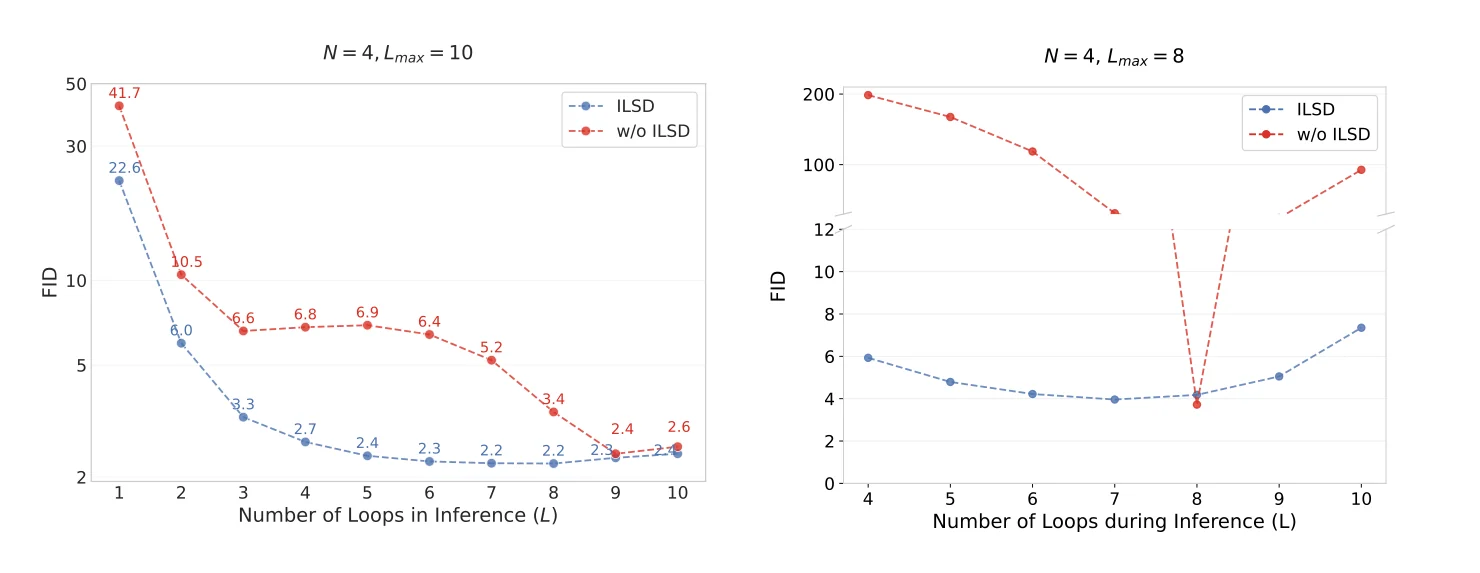
但直接按最大循环次数 $L_{\max}$ 训练的朴素 Looped Transformer,在提前截断 $L \neq L_{\max}$ 时中间隐状态几乎不可解码——MaskGIT 早期出口画质暴跌,DiT 在 $L\neq 8$ 时 FID 直接炸到 $120\text{–}200$。为此 ELT 提出 ILSD(Intra-Loop Self Distillation,循环内自蒸馏)与随机采样学生深度($S^3$,Stochastic Student Sampling):训练每一步中,完整跑完 $L_{\max}$ 遍作为教师轨迹,随机采样的中间前缀步数 $L_{\text{int}} \sim \mathcal{U}(L_{\min}, L_{\max})$ 作为学生路径共享同一个输出头,用线性衰减权重 $\lambda: 1 \to 0$ 联合优化真值损失与蒸馏损失:
$$\begin{aligned} \mathcal{L}^{\text{ILSD}}_{\Theta} &= \mathcal{L}^{\text{GT}}\!\big(F_{(N,L_{\max})}(\mathbf{x}),\,\mathbf{y}\big) + \lambda\,\mathcal{L}^{\text{GT}}\!\big(F_{(N,L_{\text{int}})}(\mathbf{x}),\,\mathbf{y}\big) \\ &\quad + (1-\lambda)\,\mathcal{L}^{\text{dist}}\!\Big(F_{(N,L_{\text{int}})}(\mathbf{x}),\,\operatorname{sg}\!\big(F_{(N,L_{\max})}(\mathbf{x})\big)\Big), \qquad L_{\text{int}} \sim \mathcal{U}(L_{\min}, L_{\max}). \end{aligned}$$关键工程亮点在于:学生状态 $F_{(N,L_{\text{int}})}$ 本来就是计算教师轨迹 $F_{(N,L_{\max})}$ 途经的前缀结果,因此 ILSD 无需任何额外教师前向(离散 MaskGIT/MAGVIT 用交叉熵,DiT 连续潜空间用 sigmoid 加权 MSE)。早期 $\lambda\approx 1$ 先靠真值锚定学生、后期转向蒸馏成熟教师,迫使 $\Theta$ 把关键细化压进更早的循环里。
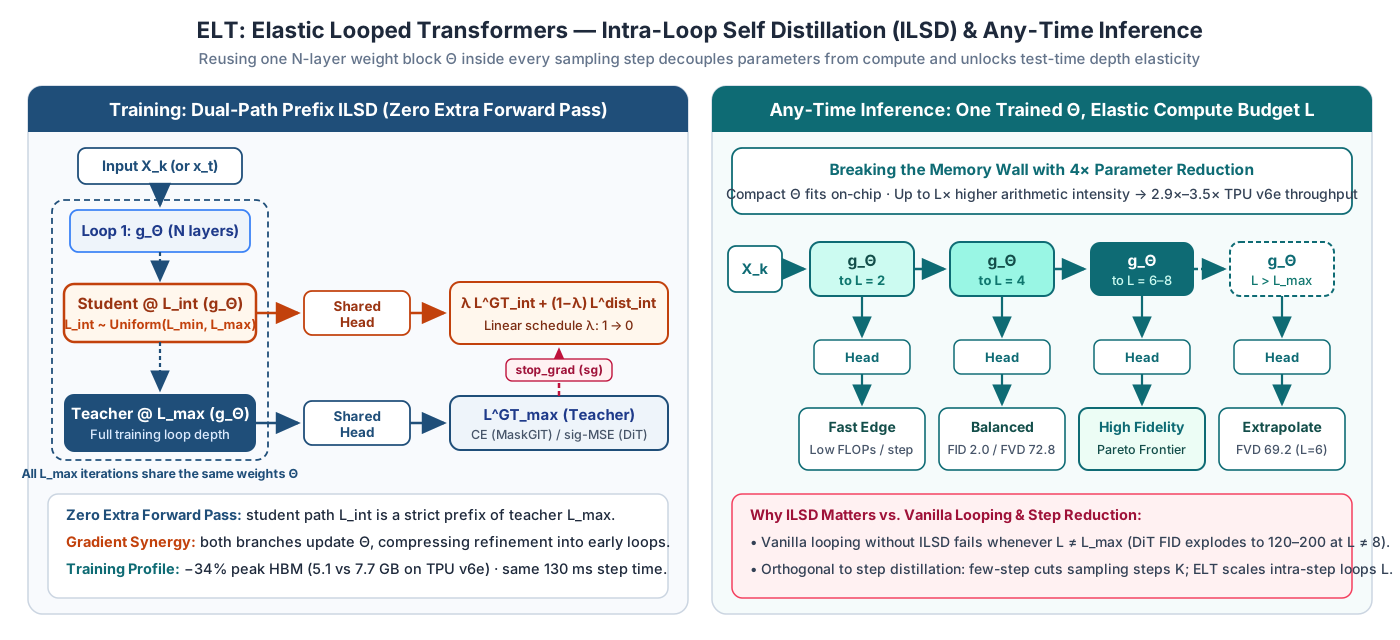
实验证明,加入 ILSD 后单次训练出的模型即可在全循环谱上平滑保持生成质量,并在视频生成 UCF-101($L_{\max}=4$)上展现温和的深度外推能力,在未见过的 $L=6$ 时把 FVD 进一步刷到 $69.20$。
4× 参数压缩、DiT 收敛加速与硬件吞吐
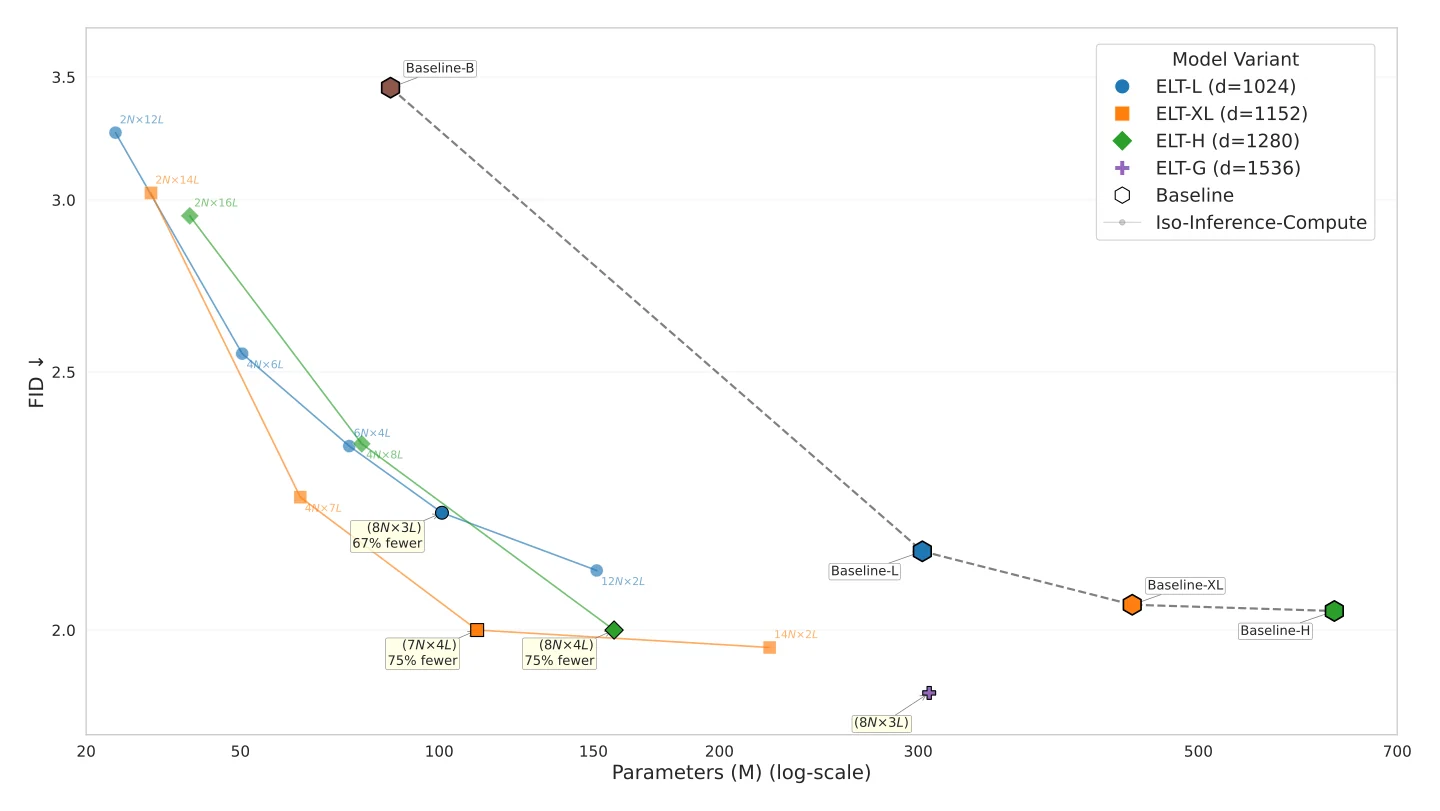
在推理等算力(iso-inference-compute)约束下横跨图像与视频生成任务,ELT 用 $2\text{–}4\times$ 更少的参数追平乃至反超不循环大基线:
- ImageNet $256\times 256$(MaskGIT):ELT-XL($7N\times 4L$,$111\text{M}$)以完全相同的 $3.9\text{k}$ GFLOPs、少 4× 参数追平 $446\text{M}$ 的 MaskGIT-XL(FID $2.0$),前沿服从幂律 $\text{FID} = 1922.5 \cdot G^{-0.95} + 1.48$。
- ImageNet $256\times 256$(DiT 与表达力下限):在 SD v1.4 潜空间 DiT(等效深度 $\mathcal{D}=32$)上,ELT($16N\times 2L$,$1.1\text{B}$)拿到 FID $2.83$、ELT($8N\times 4L$,$539\text{M}$)拿到 FID $3.16$,均显著优于 $2.1\text{B}$ 参数的 32 层 DiT 基线(FID $3.43$),且训练收敛分别快 $2.0\times$ 与 $1.4\times$;而 $1N\times 32L$($69\text{M}$)反例退化到 FID $10.30$,说明单步内独立层数 $N$ 存在表达力下限。
- UCF-101 视频生成(MAGVIT):在仅 $\sim 13.7\text{M}$ 训练 token 的受限数据集上,$76\text{M}$ ELT($6N\times 4L$)以相等的 $\sim 4.3\text{k}$ GFLOPs 击败 $306\text{M}$ 的 MAGVIT-L(FVD $72.8 \pm 2.5$ vs. $76 \pm 2$),加到 $6N\times 6L$ / 24 步更降至 $60.8$,体现出权重共享在小数据下的正则化红利。
- 打破内存墙与 TPU v6e 实测:单卡 TPU v6e 上($8N\times 4L, \mathcal{D}=32$),ELT 直接把训练峰值 HBM 显存砍掉 34%($5.1\text{ GB}$ 对 $7.7\text{ GB}$,同为 $130\text{ ms/step}$;若将循环展开为
ELTopt可进一步降至 $118\text{ ms}$ / $5.8\text{ GB}$)。推理阶段(batch 8)当紧凑权重 $\Theta$ 全部驻留片上 SRAM 时,消除重复 HBM 搬运带来 $2.9\times$(L)/ $3.3\times$(XL)/ $3.5\times$(H)的实测吞吐加速。
| ELT 配置(框架 / $\mathcal{D}$) | 参数量 | 生成指标 | 效率与硬件实测 |
|---|---|---|---|
| DiT 基线(32 层) | 2.1B | FID 3.43 | 1.0× 收敛速度 · 500K 步 |
| ELT DiT ($8N \times 4L$) | 539M (少 4×) | FID 3.16 | 1.4× 训练收敛加速 |
| ELT DiT ($16N \times 2L$) | 1.1B (少 2×) | FID 2.83 | 2.0× 训练收敛加速 |
| ELT-XL / H(TPU v6e, BS=8) | 111M (7N×4L) | FID 2.0 (MaskGIT) | 3.3×–3.5× 推理吞吐 · −34% 训练 HBM |
Looped-DiT:文生图深度监督与 Self-Modulating Attention
朴素 MMDiT 循环为何失效:深度监督与 XSA
ELT 聚焦类别条件生成并循环整套网络,而 Looped Diffusion Transformer(Looped-DiT,Chng, Chen 等[10])直面开放文本生图($512\times 512$ 像素空间 MiniT2I MMDiT,$260\text{M}$ 参数)的多约束隐式推理挑战:将 17 个 MMDiT 块按 [6, 5, 6] 切分为 Pre-loop $\mathcal{A}$、共享循环块 $\mathcal{B}$ 与 Post-loop $\mathcal{C}$,每个 flow-matching 去噪步内把中间 5 个块重复跑 $N=4$ 遍(实算 32 个块):
作者首先揪出 MMDiT 朴素循环不稳定的两大病根:
- 中间步缺乏监督:只对最后一轮 $h^{(N)}$ 算损失会让早期出口画质极差,且推理超过 $N=4$ 遍时效果不增反降。
- 无约束重复注意力擦除局部空间信息:用线性岭回归探针从循环隐状态解码 2D patch 网格坐标,发现朴素循环的定位能力从第 1 遍的 $R^2 = 0.865$ 骤跌至第 8 遍的 $0.562$(跌去 $0.303$,反而不如不循环基线的 $0.668$)。
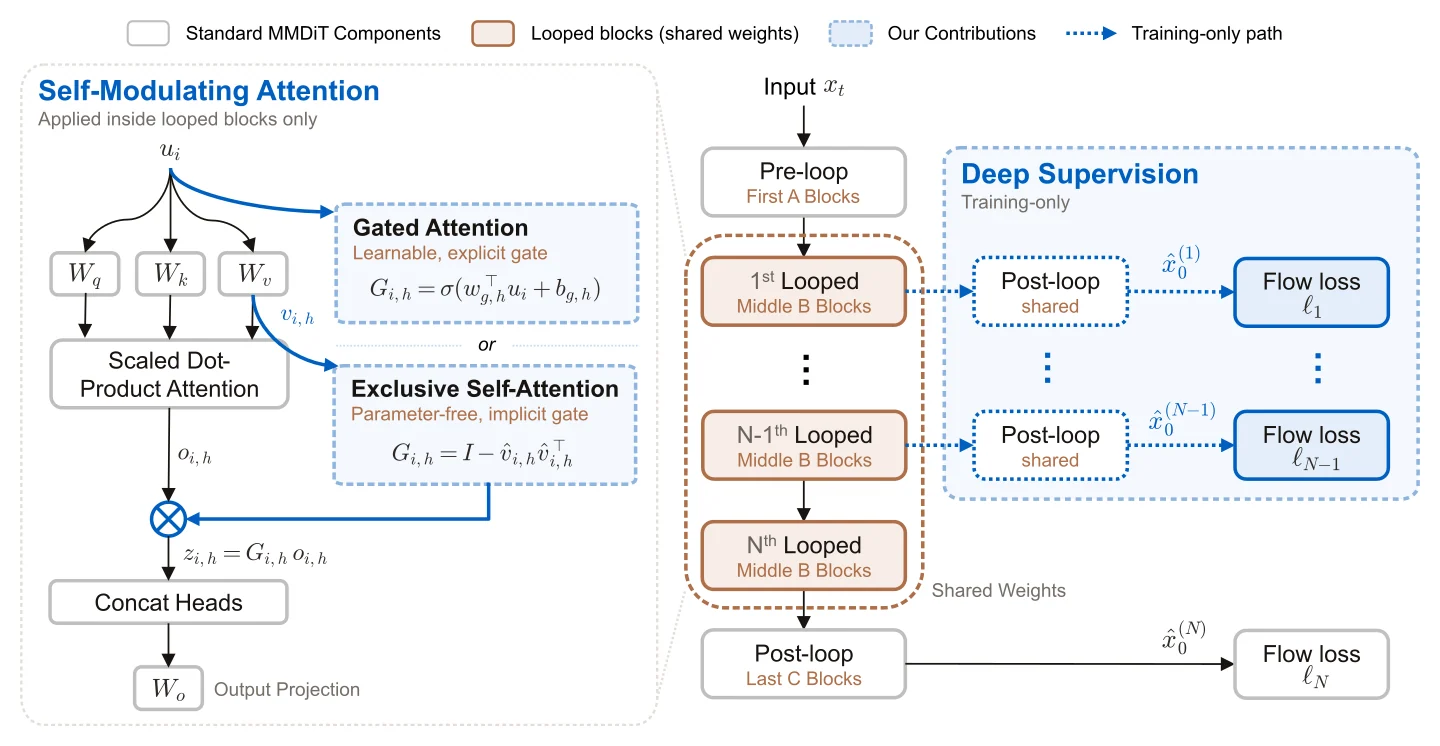
针对这两点,Looped-DiT 在 [6, 5, 6] 结构上引入了推理几乎零开销的稳定机制:
- 深度监督(Deep Supervision):仅在训练阶段把每一轮输出 $h^{(n)}$ 都喂进共享 Post-loop $\mathcal{C}$ 预测 $\hat{x}_0^{(n)} = \mathcal{C}(h^{(n)})$,对齐同一份干净图像 flow-matching 目标 $\mathcal{L} = \sum_{n=1}^N w_n \ell_n$。B/32 消融上
Final+Mean权重 $(\frac{1}{3},\frac{1}{3},\frac{1}{3},1)$ 均值达 $57.5$,赢过指数加权 $(\frac{1}{8},\frac{1}{4},\frac{1}{2},1)$ 的 $57.1$ 与朴素循环的 $56.2$(训练多花 $1.54\times$ GFLOPs—$1{,}246$ vs. $809$,但推理零额外参数和算力)。 - 轻量自适应早退门控:依托全深度中间输出监督,可额外外接一个 4-query 交叉注意力早退门控,用未来最大单轮降损 $y_r = \max\{0, \max_{k>r}(\ell_r-\ell_k)/(k-r)\}$ 做训练标签;无需重训即可在平均 $2.70$ 轮处追平 4 轮上限,并在 $1.25$ 轮超低预算下把掉点减半。
- Self-Modulating Attention(SMA / XSA):仅在循环块 $\mathcal{B}$ 内、头拼接与 $W_O$ 之前对每头注意力输出 $o_{i,h} = \sum_j \alpha_{ij,h} v_{j,h}$ 做逐 token 调制——可用可学习门控 Gated Attention,也可用完全无参数的 Exclusive Self Attention(XSA)[11] 将输出正交投影到脱离自身 value $\hat{v}_{i,h}$ 方向的子空间: $$\begin{aligned} z_{i,h} &= G_{i,h}\,o_{i,h}, \qquad G_{i,h}^{\text{gate}} = \sigma\!\big(w_{g,h}^\top u_i + b_{g,h}\big), \\ G_{i,h}^{\text{xsa}} &= I - \hat{v}_{i,h}\hat{v}_{i,h}^\top, \qquad \hat{v}_{i,h} = \frac{v_{i,h}}{\|v_{i,h}\|_2}, \qquad \big\|z_{i,h}^{\text{xsa}}\big\|_2 \le \|o_{i,h}\|_2. \end{aligned}$$ 正交投影天然不会放大向量范数($\|z\|_2 \le \|o\|_2$),并彻底消除 token 自身 value 向量反复累加带来的覆盖效应。对比实验表明 XSA 在 Looped-DiT 上一口气涨 $+1.6$ 分($57.5 \to 59.1$),而在等参数 17 层基线($-0.1$)与等算力 32 层基线($+0.7$)上收益微弱,精准印证它抑制了跨轮重复覆写(见图 18c 中杜绝后期循环多画出一个气球的幻觉)。
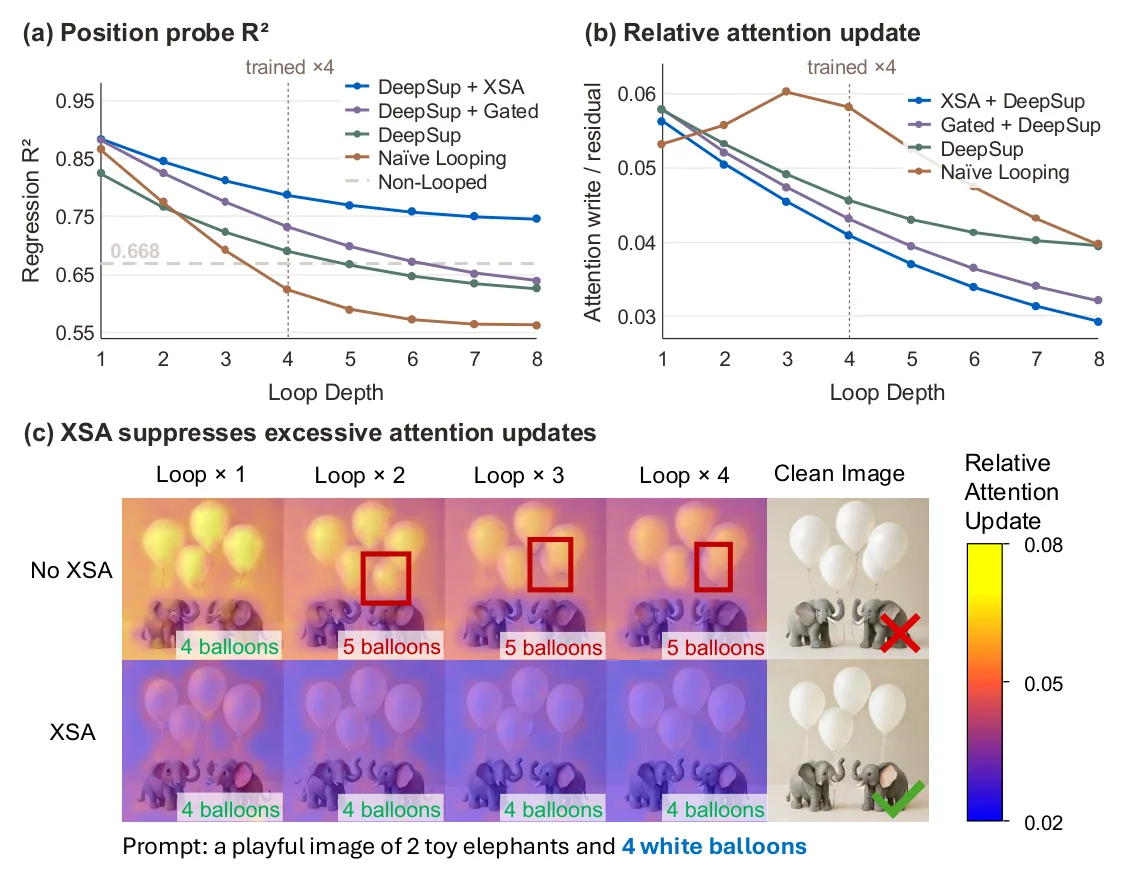
循环深度 vs. 去噪步数,以及与文本 CoT 的互补性
Looped-DiT 在大模型横评与严格控制组对照上均展现出极高的参数与算力效率:
- B/16 六项基准主结果:在 GenEval $87.4$、DPG $87.0$、PRISM $67.0$、CoRe $53.5$、Spatial $54.6$、TIIF-Short $79.7$ 上,$260\text{M}$ 的 Looped-DiT B/16 均分达到 $71.5$——不仅超越次优非循环多模态模型
InternVL-U($1.7\text{B}$,均分 $69.0$),参数量少 $6.5\times$、推理 FLOPs 少 $4.9\times$,同时也大幅领先 6.6B–6.9B 显式 CoT 生图模型(GoT-R1$63.2$、T2I-R1$63.9$、Uni-CoT$66.8$)。 - B/32 严格控制组对照:Looped-DiT($260\text{M}, 59.1$)全面击败等参数
MiniT2I($55.2$)、等推理算力加厚/加宽基线(Deeper$473\text{M}, 57.7$;Wider$489\text{M}, 58.6$),乃至同样加深度监督的等训练算力 32 层基线(Deeper + DeepSup$473\text{M}, 1{,}246\text{ GFLOPs}, 58.1$)。
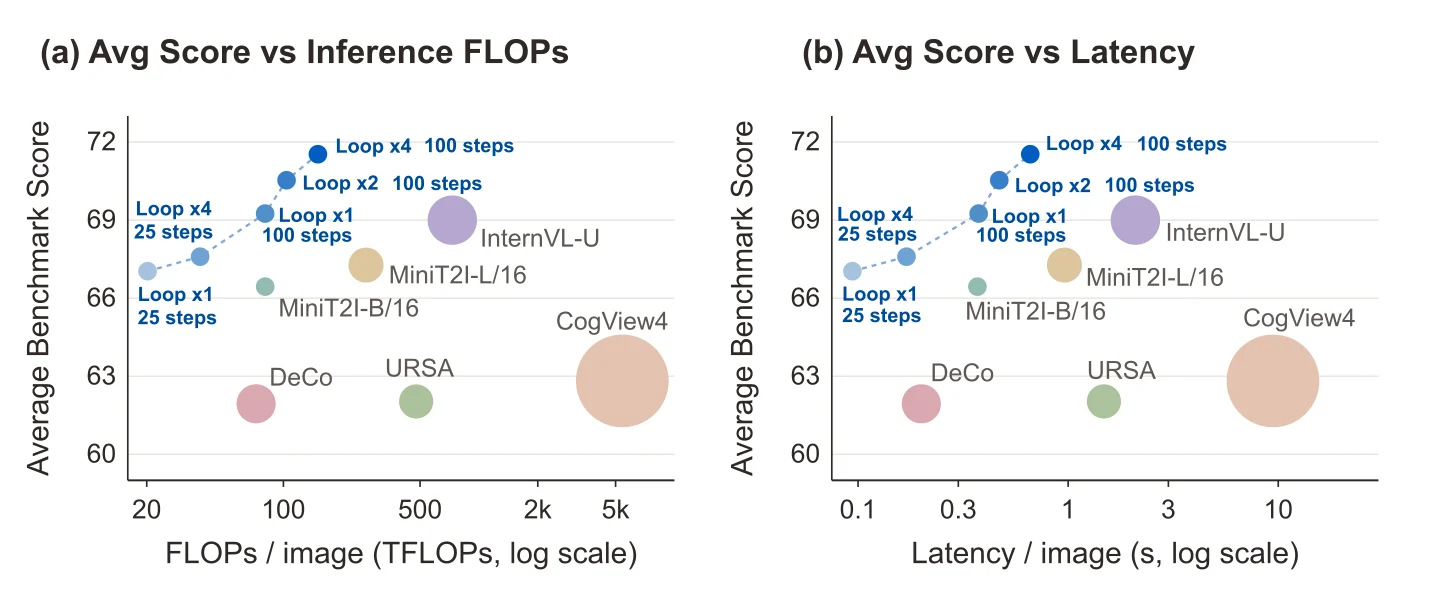
围绕「视觉生成该怎样分配推理算力」,Looped-DiT 还给出了两项极具启发性的结论:
- 等推理 FLOPs 下,加深循环比多跑去噪步数更划算:在 $14 / 20 / 28$ TFLOPs 三个对齐档位,把预算配给
Loop × 4($25/35/50$ 步)在全部四个推理基准上稳赢双倍去噪步数的Loop × 1或不循环版本($50/70/100$ 步,图 20)。 - 潜空间循环与显式文本 CoT 精准互补:当提示词需要满足多重关系、步骤或空间方位约束时,Looped-DiT 贡献了绝大部分涨幅;当任务需要靠文字先补全隐含物理/常识画面时,Qwen3 CoT 重写更强,二者叠加可达 $+5.5$ 总分峰值(表 5)。
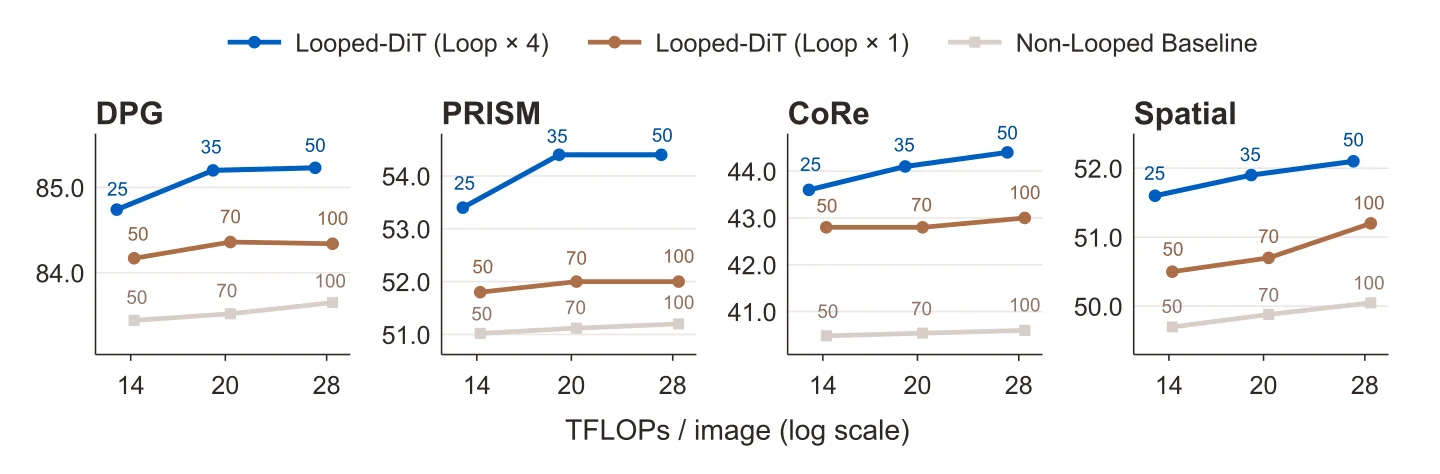
Loop × 4 全面胜过把算力加到双倍去噪步数($50\text{–}100$ 步)。来源:Chng, Chen 等,Looped Diffusion Transformer[10]。| T2I 子任务 / 能力类型 (B/32) | 仅文本 CoT | 仅 Looping | CoT + Looping |
|---|---|---|---|
| 四项基准均分涨幅 | +2.1 | +4.0 | +5.5 |
| PRISM / 长文本约束 | +3.1 | +9.1 | +9.4 |
| CoRe / 多关系与流程约束 | +1.2 / +4.7 | +8.3 / +9.4 | +8.4 / +9.6 |
| Spatial / 方位与动作约束 | +0.0 / +0.1 | +6.0 / +6.0 | +6.2 / +6.3 |
| CoRe / 隐含画面推断 (Gen.) | +22.2 | +7.5 | +24.5 |
把语言模型与视觉生成的五套循环方案放在同一框架里:想让共享权重「多跑几遍还能越算越好」,必须同时管住两件事:
- 控制跨轮写入失控与特征漂移:SMELT 靠 $1/r$ 残差缩放、Truncate or Not? 靠 $s_0$ Input Injection、Inkling 2 Mini 靠双路门控 AttnRes,Looped-DiT 则靠无参数 XSA 正交消去 token 自身 value 向量的反复叠加。
- 保证中间轮次的梯度供给:语言模型只在终点算 next-token loss,因此依赖完整 BPTT($B=T$);而视觉生成天然在每一轮都面对同一个去噪/重建目标,正好能用 ILSD 前缀自蒸馏 或共享 Post-loop 深度监督 直接对齐所有中间轮。
架构与训练启示
- MoE + 中间层循环才是等算力赢家:单独看稠密模型容易陷入“省参数就丢容量”的死结;把中间 50% MoE 层循环两遍并用新增专家补足总容量、同时放宽深宽比和对齐 KV,就能在严格等预算下实打实赚回 6.8–18.0% 训练算力和更好的长程推理能力。
- 算力优先给完整反传,别为了多空转前向截断:因为每一轮完整反传带来的有效参数增益远远高过仅多跑前向($q\approx 1.02 \gg 2p\approx 0.47$),$(4,4)$ 在同算力下稳赢 $(8,2)$;只有前向轮数因推理时延或固定架构被锁死高值时,才值得靠 $B^*=2$ 截断减负。
- 用块级 Attention Residuals 接管跨轮信息流:用 Depth-wise + Cross-Loop Attention 替代单一累加残差后,权重无需额外人工监督就能在块末层自发演化出 $d_{2027}$ 这类兼任“路由标签”与“出循环清零”的稀疏控制通道,而且全程仍可通过 Coda-lens / Tuned-lens 保持可解释性。
- 视觉生成里必须直接监督中间循环出口:因为扩散去噪与 Masked Generative 重建在所有深度上共享同一目标,无论是通过 ILSD 前缀自蒸馏($\lambda: 1\to 0$) 还是共享 Post-loop 深度监督(
Final+Mean),都能零推理成本消除早退崩塌,换取 $4\text{–}6.5\times$ 参数压缩与 Any-Time / 自适应算力调节。 - 管住循环内过写,把步数算力挪一部分给步内循环:未经约束的循环注意力会抹掉 2D 空间坐标($R^2: 0.865\to 0.562$),而无参数 XSA 能直接稳住空间拓扑;同等推理 FLOPs 下增加步内循环往往优于盲目加去噪步数,并与文本 CoT 形成互补。
引用本文
如果本文的整理或图示对你有帮助,欢迎引用:
Chaoran Feng (2026). "Looped Transformers: Compute-Matched Scaling, Training Gradients, and Internal Circuits". Chaoran Feng's Blog. https://www.falcary.com/blogs/looped-transformers/
@article{feng2026looped,
  title   = {Looped Transformers: Compute-Matched Scaling, Training Gradients, and Internal Circuits},
  author  = {Feng, Chaoran},
  year    = {2026},
  month   = {November},
  url     = {https://www.falcary.com/blogs/looped-transformers/}
}
参考文献
- SMELT: Scaling Laws for Compute-Matched MoE Looped Transformers. Wang, Zhang et al., Tsinghua University, ByteDance Seed, M-A-P, and TokenWave.AI, 2026 (arXiv:2609.01343).
- Truncate or Not? A Scaling Study of Looped Transformers with Truncated Backpropagation. Xiong, Chen et al., HKU MMLab and Yale University, 2026 (arXiv:2610.26030).
- Introducing Inkling 2 Mini. Thinking Machines Lab, November 20, 2026.
- Interpreting Inkling 2 Mini. Lee, Krishnamurthy, Merullo, Balsam, and Lubana, Goodfire, November 20, 2026.
- Inkling 2 Mini Model Card. Thinking Machines Lab, November 20, 2026.
- Universal Transformers. Dehghani, Gouws, Vinyals, Uszkoreit, and Kaiser, ICLR 2019 (arXiv:1807.03819).
- Scaling up Test-Time Compute with Latent Reasoning: A Recurrent Depth Approach. Geiping et al., NeurIPS 2025 (arXiv:2502.05171).
- Attention Residuals. Kimi Team: Chen et al., 2026 (arXiv:2603.15031).
- ELT: Elastic Looped Transformers for Visual Generation. Goyal, Agrawal, Anil, Jain, Paul, and Kusupati, ECCV 2026 (arXiv:2604.09168).
- Looped Diffusion Transformer. Chng, Chen, Tong, Diao, Cai, Yang, Liu, Lu, Lin, and Huang, SenseTime Research, Tsinghua University (LeapLab), and NTU, 2026 (arXiv:2609.40305).
- Exclusive Self Attention. Zhai, 2026 (arXiv:2603.09078).